Blog
블로그
전체 글 3페이지예요.
글 154편
구글 AI 모드가 답을 직접 그려줄 때, 콘텐츠는 어떻게 인용되나요
구글이 2025년 11월 AI 모드에 Gemini 3를 넣어 질문마다 맞춤 레이아웃과 인터랙티브 도구를 즉석에서 만들어요. 답이 생성형 UI로 바뀌어도 웹 고품질 콘텐츠로 가는 눈에 띄는 링크는 유지돼요. 생성형 검색에서 콘텐츠가 인용되는 조건을 정리했어요.
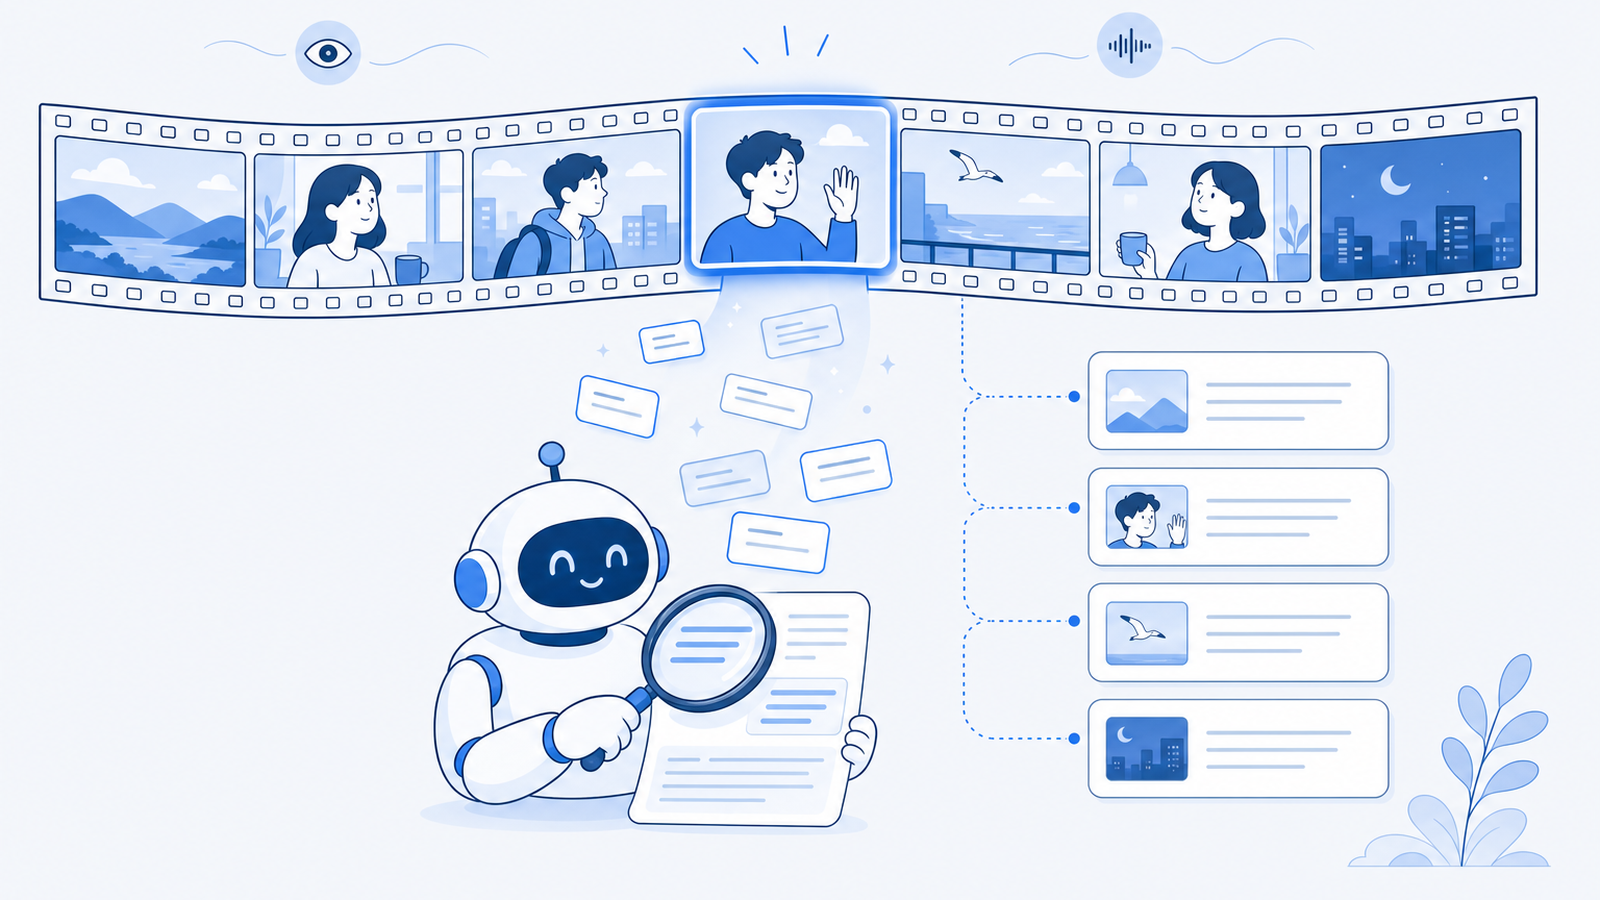
Video-RAG, 긴 영상 이해에서 프레임을 늘리는 대신 OCR·음성 텍스트를 검색
Video-RAG는 긴 영상에서 프레임을 늘리는 대신 OCR, 음성 인식, 객체 검출 텍스트를 질문으로 검색해 넣어요. 학습 없이 Video-MME 등에서 성능을 올린 NeurIPS 2025 논문을 정리했어요.
DeepSeek V4.1 Flash 해부, KV 캐시는 줄고 사후학습 레시피는 그대로
DeepSeek V4.1 Flash 기술 보고서를 원문으로 읽었어요. KV 캐시를 V4의 4분의 1로 줄인 구조와, SFT·RL·온폴리시 증류를 V4 그대로 쓴 사후학습을 정리했어요.
LLM 위키에서 Open Knowledge Format까지, 에이전트가 쓰는 지식베이스
카파시의 LLM 위키와 구글의 Open Knowledge Format(OKF)을 원문으로 읽고 연결했어요. 에이전트가 쓰는 지식베이스의 형식, RAG와의 차이, v0.2의 출처·확인 필드를 정리했어요.
강화학습 정렬의 한계는 어디인가, 학습 전에 계산하는 보상의 천장
강화학습으로 언어 모델을 정렬할 때 얻을 수 있는 보상의 천장을 학습 전에 계산한 연구예요. Best-of-N은 천장에 붙었고 PPO와 GRPO는 아래에 머물렀으며, 보상 해킹이 왜 생기는지도 식으로 풀었어요.
AI 검색에 인용되려 콘텐츠를 고칠 때, 전략과 지어내는 위험
AI 검색에 인용되려고 콘텐츠를 고치는 자기진화 에이전트 연구예요. 진화된 전략이 고정 기법을 이기고 재작성은 1-3번이면 충분했지만, 점수만 보상하면 합성 인용이 전략으로 살아남는 위험이 드러났어요.
구글 AI 개요는 언제 뜨나요, 검색 상위 없이도 인용될까
구글 AI 개요는 미국 트렌드 질의의 13.7%에만 뜨고, 질문형에서 6.8배 더 자주 떠요. 인용 도메인의 30%는 검색 1페이지 밖이고, 주장의 11%는 인용 페이지가 뒷받침하지 않았어요. 40일 관측 연구예요.
TRAIL Labs가 Google for Startups 클라우드 프로그램에 선정됐어요
TRAIL Labs가 Google for Startups 클라우드 프로그램에 선정됐어요. 클라우드 크레딧과 기술 지원을 활용해 AI 검색 가시성 측정과 콘텐츠 생성 엔진을 더 큰 규모로 키우려 해요.
TRAIL Labs가 NVIDIA 인셉션 프로그램에 선정됐어요
TRAIL Labs가 NVIDIA 인셉션(Inception) 프로그램에 선정됐어요. 컴퓨팅과 기술 자원, 네트워크를 활용해 AI 검색 가시성 측정과 콘텐츠 생성 엔진을 키워 나가려 해요.
AI 검색 가시성은 한 번 재면 못 믿어요, 몇 번·며칠을 재야 할까
AI 검색 가시성은 한 번 재면 믿기 어려워요. 같은 질문인데 인용 소스가 하루 새 약 65%가 바뀌고, 원인은 상당 부분 모델의 확률적 생성이에요. 믿을 만한 측정에 필요한 반복 횟수와 기간을 정리했어요.