지역 실험으로 마케팅 믹스 모델 보정하는 법: ROAS 숫자 하나 대신 시계열 전체를 쓴다
처치 지역과 대조 지역의 차이만 남기면 이월·포화·효과 크기 세 파라미터가 실험에서 바로 나온다. 2026년 구조 추정 논문 정리
지역 실험으로 마케팅 믹스 모델을 보정할 때 ROAS 숫자 하나만 쓰면 이월과 포화 정보가 버려진다. 처치·대조 차분식으로 세 파라미터를 추정해 MMM의 ROAS 과대추정을 바로잡은 2026년 논문을 원문 수치로 정리했다.
지역 실험으로 마케팅 믹스 모델을 보정할 때, 실험을 ROAS 숫자 하나로 줄이지 말고 처치 지역과 대조 지역의 주간 매출 차이를 시계열 그대로 쓰면 이월·포화·효과 크기 세 파라미터를 실험에서 직접 추정할 수 있다. Niklas Heusch가 2026년 8월 arXiv에 올린 Structural Estimation of Marketing Mix Model Parameters from Geo-Experiments[1]가 이 방법을 제안한다. 합성 데이터에서 실제 ROAS는 4.20배였고, 관측 데이터로 추정한 MMM은 10.66배, 실험 네 번을 쓴 이 방법은 4.14배였다[1]. 근거는 전부 합성 데이터다.
이 글은 arXiv v2 원문(12쪽, 동료심사 전)을 부록까지 읽고 표의 수치를 원문과 대조해 쓴다[1]. 저자는 단독이고 연락처는 Zalando 이메일이다. 데이터는 같은 저자가 공개한 합성 벤치마크[2]에서 나왔다.
우리는 AI 답변 속 브랜드 언급을 반복 측정하는 제품을 만들고 있어서 측정 방법론에 이해관계가 있다. 이 논문의 방법을 직접 돌려 보지는 않았고, 원문의 수치를 옮겼다. 지난 글 증분 실험으로 마케팅 믹스 모델 보정하기에서는 실험 ROAS를 사전분포에 꽂는 Google의 방법을 다뤘다[3]. 이 논문은 그 방법이 버리는 정보를 문제 삼는다.
MMM은 왜 ROAS를 과대추정하나
광고 예산은 무작위로 정해지지 않고 수요를 따라 움직이기 때문에, 관측 데이터만 쓰는 마케팅 믹스 모델(MMM)은 그 상관을 광고 효과로 읽는다[1]. 회사는 매출이 오를 것으로 보이는 시기에 예산을 늘리고, 자동 입찰은 전환이 잘 나오는 주에 지출을 올린다. 모델은 매출이 광고 때문에 올랐는지, 매출이 오를 줄 알고 광고를 늘렸는지 구분하지 못한다.
MMM이 인과 효과를 내려면 통제 변수를 조건으로 뒀을 때 오차항이 지출과 독립이어야 한다[1]. 예상 수요, 경쟁사 움직임, 입소문처럼 예산과 매출을 함께 움직이는 요인을 전부 관측해 넣어야 한다는 뜻이다. Facebook의 대규모 현장 실험 비교도 관측 방법이 무작위 실험의 결과를 복원하지 못한다고 보고했다[5].
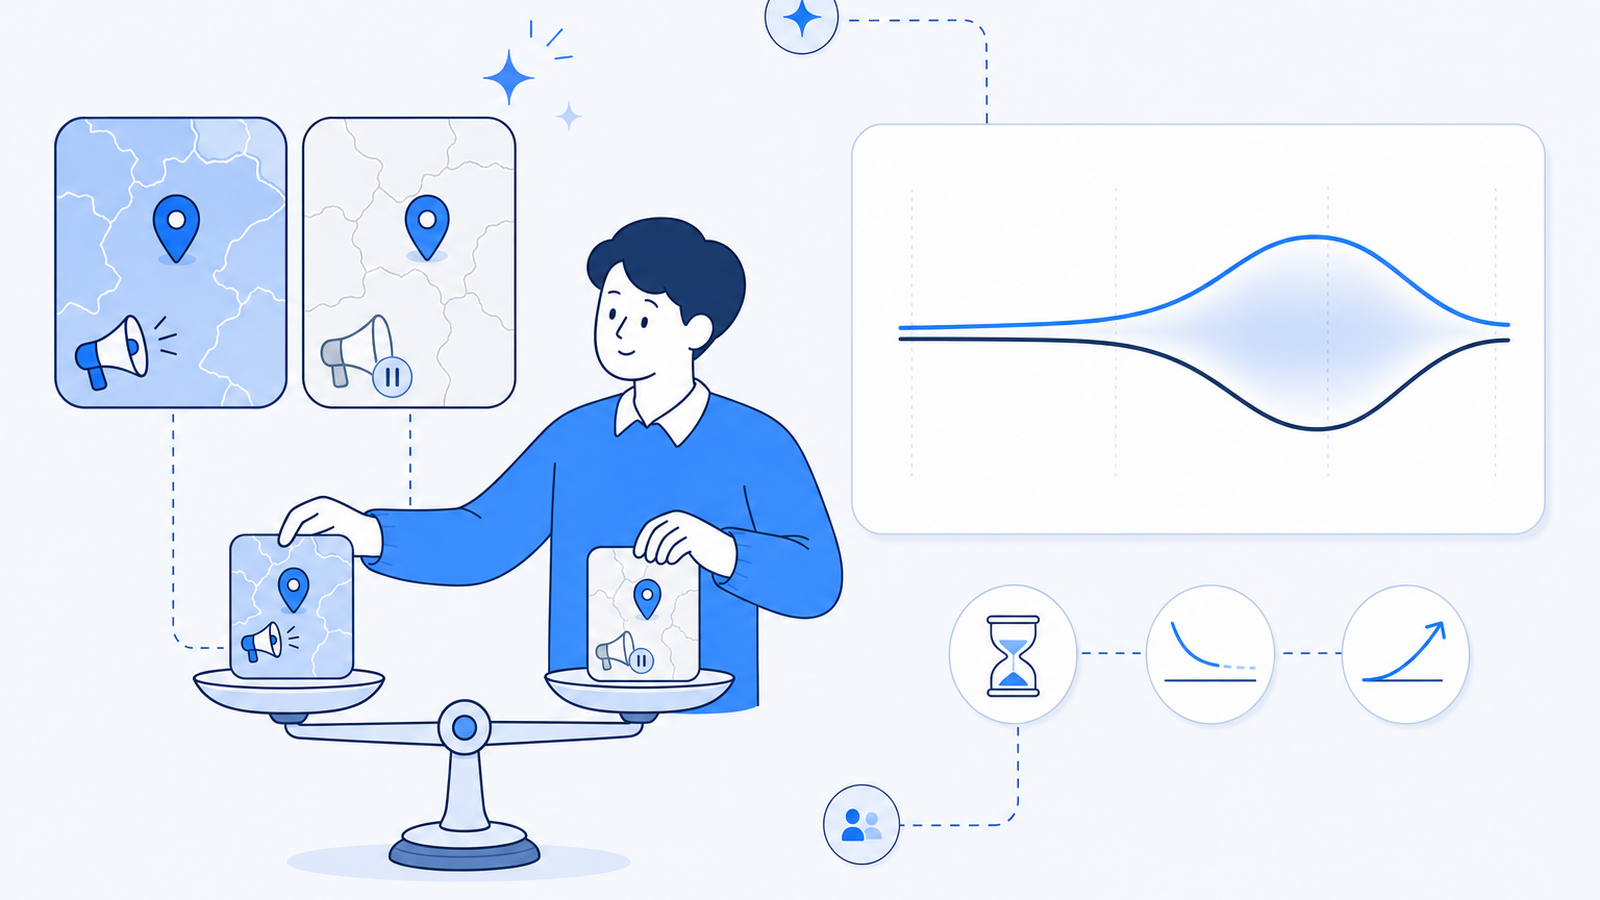
지역 실험은 이 문제를 무작위 배정으로 끊는다. 시장을 지역 단위로 나눠 처치군과 대조군에 무작위로 배정하고, 실험 기간에 처치군의 광고를 바꾼다. 흔한 설계는 처치군의 광고를 0으로 끄는 방식이다[1].
지역 실험을 ROAS 숫자 하나로 줄이면 무엇이 버려지나
실험을 ROAS 하나로 요약하면 이월(adstock)과 포화를 알려 주는 시간 변화가 전부 사라진다[1]. 표준 관행은 실험 기간의 매출 차이 합계를 지출 차이 합계로 나눈다.
여기서 는 주의 매출, 는 그 주의 광고 지출이다. 이 값은 평균 수익률을 알려 주지만, 효과가 몇 주에 걸쳐 이어지는지와 지출이 늘 때 얼마나 빨리 줄어드는지는 알려 주지 않는다.
실험 시계열에는 두 신호가 그대로 들어 있다[1]. 광고를 끄면 매출 차이는 즉시 벌어지지 않고 처치군의 이월이 소진되는 속도로 벌어지며, 광고를 다시 켜면 같은 속도로 닫힌다. 이 전환 속도가 이월 감쇠율을 정한다. 지출 수준이 다른 실험을 비교하면 지출이 두 배일 때 차이가 두 배에 못 미치는 정도가 보이고, 이것이 포화 곡선의 모양이다.
기존 보정 방법 세 가지는 모두 실험을 집계 통계로 줄인다는 점에서 같다[1].
| 방법 | 실험을 넣는 통로 | 식별하는 것 | 놓치는 것 |
|---|---|---|---|
| Google Meridian | ROAS를 파라미터로 세우고 실험값을 사전분포로[3] | 효과 수준 | 지출 수준이 다른 실험의 구분, 이월, 포화 |
| Meta Robyn | 실험 리프트와의 차이를 세 번째 목적 함수로 | 총효과 제약 | 이월과 포화의 분리 |
| PyMC-Marketing | 리프트 관측을 우도에 추가, 포화 곡선 위의 점으로[6] | 포화 | 이월 |
| 차분 구조 추정 | 주간 차분 시계열을 우도로 | 이월, 포화, 효과 크기 | 실험 범위 밖의 곡선 |
표 1. 실험으로 MMM을 보정하는 네 방법의 비교. 출처: Heusch 2026, 6장 B절[1]의 서술을 표로 옮김.
차분식: 처치 지역에서 대조 지역을 빼면 무엇이 남나
처치군과 대조군의 매출을 빼면 테스트 채널의 세 파라미터와 관측된 지출만 남는다[1]. 논문은 두 집단을 테스트 채널의 광고만 다른 평행 세계로 놓는다. 각 집단의 매출은 공통 항 와 채널 효과의 합이다.
에는 기본 수요, 다른 채널의 기여, 가격과 프로모션, 계절성, 관측되지 않는 요인이 전부 들어간다. 무작위 배정 때문에 이 항은 두 집단에서 같고, 빼면 사라진다.
여기서 는 이월 변환을 거친 지출, 은 포화 함수, 는 두 집단 오차의 차이다. 이월은 최근 주 지출의 가중 평균이고, 포화는 로지스틱 함수다.
- : 이월 감쇠율. 0이면 이번 주 지출만 영향을 주고, 클수록 지난 지출이 오래 남는다.
- : 포화 속도. 클수록 낮은 지출에서 수익 체감이 시작된다.
- : 효과 크기. 포화된 이월을 증분 매출 금액으로 바꾼다.
통제 변수가 교란 요인을 다 잡았다고 가정할 필요가 없고, 예산이 어떻게 정해지는지 모델링할 필요도 없다[1]. 식별은 실험 설계에서 나온다.
추정 절차: 넓은 형식으로 펴고, 실험을 쌓고, 베이지안으로 추정한다
데이터 준비의 핵심은 한 행이 한 주의 관측을 완결하도록 넓은 형식으로 바꾸는 것이다[1]. 각 행에는 그 주의 매출 차이, 그리고 두 집단의 이번 주와 지난 주 지출이 들어간다. 행끼리 시간 의존이 없어지므로 1월 실험과 6월 실험의 행을 그냥 위아래로 쌓으면 된다.
[지역 실험 시계열]            [넓은 형식]                  [추정]
 처치·대조 주간 매출   →   한 행 = 매출 차이          →   차분식의 우도
 처치·대조 주간 지출        + 두 집단 지출(현재+시차)       α, λ, β 사후분포
        │                         │                          │
   사전·실험·회복 구간      실험 여러 번을 행으로 쌓기       ROAS와 반응 곡선
지역 실험은 전국보다 규모가 작으므로 MMM과 같은 척도로 맞춘다. 처치군이 전국의 40%이면 매출과 지출을 0.4로 나눠 전국 규모로 환산하고, MMM이 쓰는 변환(최댓값으로 나누기 등)을 똑같이 적용한다[1].
사전분포는 PyMC-Marketing v0.19의 기본값이다[1]. PyMC-Marketing이 실험을 넣는 기존 방식은 리프트 테스트 보정 문서[6]에 있다. 비교 대상인 관측 MMM도 매체 파라미터에 같은 사전분포를 써서, 두 방법의 차이가 사전분포 선택에서 나오지 않도록 했다.
| 파라미터 | 사전분포 | 근거 |
|---|---|---|
| Beta(1, 3) | 디지털 채널의 짧은 이월 | |
| Gamma(3, 1) | 양수, 최빈값 2 | |
| HalfNormal(2) | 양의 효과 | |
| HalfNormal(0.5) | 관측 잡음 |
표 2. 구조 추정 모형의 사전분포. 출처: Heusch 2026, 표 1[1].
추정은 PyMC의 NUTS로 4개 체인을 돌리고, 노트북에서 30초 안에 끝난다[1].
합성 데이터 결과: 실제 ROAS 4.20배, MMM은 10.66배, 구조 추정은 4.14배
관측 데이터로 추정한 MMM은 ROAS를 약 2.5배 과대추정했고, 실험 시계열로 추정한 구조 모형은 참값을 90% 구간 안에 넣었다[1]. 합성 데이터는 유료 검색, 소셜, TV 세 채널을 가진 온라인 소매업체의 156주다. 예산이 예상 수요에 반응하고 입찰 알고리즘이 성과를 따라가도록 만들어서, 지출이 내생적이다[2].
실험은 유료 검색 채널에 네 번 했다. 각 실험은 사전 4주, 실험 4주(처치군 지출 0), 회복 8주로 16주를 전부 추정에 쓴다. 대조군의 주간 평균 지출은 5.4만, 12.9만, 6.4만, 5.7만 유로로 달랐고, 네 실험을 합치면 이월 지출 기준 주당 약 4.3만에서 19.4만 유로 구간을 훑는다[1].
| 방법 | ROAS | 90% 구간 | 참값 포함 |
|---|---|---|---|
| 참값 | 4.20배 | 해당 없음 | 해당 없음 |
| MMM (실무 사양) | 10.66배 | 6.99–14.42 | 아니오 |
| MMM (실제 교란 요인 통제) | 8.45배 | 6.97–9.82 | 아니오 |
| 구조 추정 (실험 2번) | 4.31배 | 3.87–4.74 | 예 |
| 구조 추정 (실험 4번) | 4.14배 | 3.77–4.51 | 예 |
표 3. 유료 검색 채널의 ROAS 추정 비교. 실무 사양은 프로모션 더미, 프로모션 가격, 연간 푸리에 항 3개를 통제 변수로 쓴다. 출처: Heusch 2026, 표 2[1].
둘째 행이 이 논문에서 가장 눈에 띄는 결과다. 데이터를 만든 실제 교란 요인(실제 프로모션 상태, 가격 수준, 계절 성분, 제품 품질 변화, 시장 심리)을 전부 넣은 모델도 8.45배로 추정했다[1]. 실무자는 가질 수 없는 변수를 줘도 편향이 절반 가까이 남았다는 뜻이다. 저자는 두 원인을 든다. 입찰 알고리즘이 그 주의 우연한 성과 변동에도 반응해서 어떤 공변량으로도 흡수되지 않고, 실제 기준선은 성분들이 곱으로 결합하는데 통제 변수는 선형으로 들어간다.
파라미터 수준에서도 차이가 난다.
| 방법 | (이월) | (포화) | (효과 크기) |
|---|---|---|---|
| 참값 | 0.20 | 1.71 | 0.18 |
| 구조 추정 (실험 2번) | 0.18 [0.08, 0.29] | 2.28 [0.91, 3.48] | 0.17 [0.11, 0.32] |
| 구조 추정 (실험 4번) | 0.19 [0.09, 0.28] | 1.94 [0.65, 3.10] | 0.20 [0.11, 0.44] |
| MMM (실무 사양) | 0.50 [0.37, 0.62] | 1.27 [0.38, 2.62] | 0.86 [0.30, 2.03] |
표 4. 파라미터 추정 비교. 대괄호는 90% 신용구간이고, 와 는 추정 척도(지출과 매출을 각각 최댓값으로 나눈 값) 기준이다. 출처: Heusch 2026, 표 3[1].
관측 MMM은 이월을 0.20 대신 0.50으로, 효과 크기를 참값의 몇 배로 추정했다[1]. 구조 추정에서 이월은 참값에 거의 붙었지만 와 의 구간은 넓다. 채널 효과를 숫자 하나로 읽지 말아야 하는 이유는 베이지안 MMM의 신용구간에서 다뤘다.
포화와 효과 크기는 따로 식별되지 않는다: 반응 곡선으로 읽어야 한다
와 는 사후 상관이 −0.68로 함께 움직이고, 데이터가 좁게 고정하는 것은 두 값이 만드는 반응 곡선이다[1]. 완만한 곡선에 큰 계수를 곱한 것과 가파른 곡선에 작은 계수를 곱한 것이 실험이 다룬 지출 범위에서는 거의 같은 반응을 낸다. 그래서 ROAS의 구간은 좁은데 파라미터 각각의 구간은 넓다.
실험이 훑은 지출 범위 안에서는 사후 반응 곡선이 참 곡선과 겹치고, 범위 밖에서는 부채꼴로 퍼진다[1]. 예산을 실험 범위 훨씬 위로 늘리는 권고는 실험이 뒷받침하지 못하고, 포화 함수의 모양 가정에 기대게 된다. 포화와 시간에 따라 변하는 효과가 관측 데이터로 구분되지 않는다는 지적은 Dew 등의 논문에도 있다[4].
사전분포를 바꿔도 결과는 거의 같았다. 구조 추정의 ROAS는 넓은 사전분포에서 4.07배, 좁은 사전분포에서 4.14배로 점 추정이 2% 안에서 움직였다[1]. 관측 MMM은 사전분포를 바꿔도 11.67배로 편향이 그대로였다. 과대추정의 원인이 사전분포 선택보다 데이터의 내생성에 있다는 뜻이다.
한계
이 논문의 결과는 전부 저자가 만든 합성 데이터에서 나왔고, 실제 기업 실험에 적용한 결과는 없다[1]. 저자가 밝히거나 원문에서 확인되는 한계는 다음과 같다.
- 합성 데이터를 만든 함수 형태(기하 이월, 로지스틱 포화)와 추정 모형의 함수 형태가 같다. 모형이 틀렸을 때의 성능은 보지 않았다.
- 채널 하나(유료 검색), 이월이 짧은 경우()만 실험했다. TV처럼 이월이 긴 채널의 결과는 없다.
- 지역 간 번짐이 없다고 가정한다. 대조 지역의 광고가 처치 지역 소비자에게 닿으면 효과가 과소추정된다.
- 파라미터가 실험 기간 사이에 변하지 않는다고 가정한다. 소재 피로나 경쟁 상황이 바뀌면 추정치는 평균에 가까운 값이 된다.
- 실험 설계 요구가 표준보다 높다. 2주짜리 실험은 이월을 식별하기에 짧을 수 있고, 포화를 보려면 지출 수준이 다른 실험이 여러 번 필요하다.
- 여러 채널을 가진 전체 MMM과 합치는 방법(사전분포로 넘기기, 결합 우도, 2단계 추정)은 제안만 하고 실험하지 않았다.
- 동료심사 전 원고이고 단독 저자다.
TRAIL에서 보는 것
이 논문의 문제는 GEO 측정에도 같은 모양으로 나타난다. 브랜드는 수요가 붙을 것 같은 제품과 페이지부터 고친다. 고친 페이지의 언급이 늘었을 때 그것이 수정 효과인지, 원래 관심이 오르던 주제였는지는 전후 비교로 구분되지 않는다. AI 답변 노출을 MMM의 입력으로 만드는 틀은 GEO 효과를 매출로 재는 법에서 다뤘다.
TRAIL Search는 질문 세트를 플랜에서 선택한 엔진에 정기적으로 묻고, 언급과 순위, 인용 URL을 엔진과 질문, 확인 시각 단위로 기록한다. 매출과 광고 지출은 우리 측정 범위 밖이어서, 우리 숫자만으로 ROAS를 말할 수는 없다. 이 논문에서 측정 설계로 가져올 기준은 세 가지다.
- 요약값 하나보다 시계열. 조치 뒤 언급률이 며칠에 걸쳐 변했는지에 지속 정보가 들어 있고, 전후 평균 하나로 줄이면 그 정보가 사라진다.
- 비교군과의 차이. 조치하지 않은 페이지나 질문군을 같은 기간에 재서 빼야 엔진 업데이트와 계절 변화가 상쇄된다. 설계 기준은 AI 검색 노출 실험 설계법에 정리해 두었다.
- 실험한 범위 안에서만 말하기. 질문 20개에서 확인한 효과를 질문 2,000개로 늘려 말하는 것은 이 논문의 범위 밖 외삽과 같은 종류의 주장이다.
저자는 노트북과 데이터를 공개했다고 밝힌다[1][2]. 직접 돌려 보려면 합성 벤치마크 논문의 데이터 생성기에서 시작하면 된다.
자주 묻는 질문
지역 실험 결과를 MMM에 넣는 지금의 방식은 무엇이 문제인가?
실험 하나를 ROAS 숫자 하나로 줄여서 넣는다는 점이다. 총 증분 매출을 총 증분 지출로 나누면 평균 수익률은 남지만, 광고를 끊은 뒤 매출 차이가 몇 주에 걸쳐 벌어지고 닫혔는지(이월), 지출 수준이 다른 실험에서 차이가 얼마나 달랐는지(포화)는 사라진다. 이 논문은 주 단위 시계열을 그대로 써서 세 파라미터를 함께 추정한다.
MMM은 왜 ROAS를 과대추정하나?
광고 예산이 무작위로 정해지지 않기 때문이다. 수요가 높을 것으로 보이는 시기에 예산을 늘리고, 자동 입찰은 성과가 좋은 주에 지출을 올린다. 관측 데이터만 보는 모델은 이 상관을 광고 효과로 읽는다. 논문의 합성 데이터에서 실제 ROAS는 4.20배였는데 실무 사양의 MMM은 10.66배로 추정했다.
통제 변수를 더 넣으면 해결되나?
이 논문의 실험에서는 아니었다. 데이터를 만든 실제 교란 요인을 전부 통제 변수로 넣은 모델도 8.45배로 추정했고, 90% 구간이 참값을 포함하지 못했다. 입찰 알고리즘이 그 주의 우연한 성과 변동에도 반응하기 때문에 어떤 공변량으로도 흡수되지 않는 상관이 남는다.
이 방법을 쓰려면 실험을 어떻게 설계해야 하나?
이월을 식별하려면 광고를 끊은 뒤와 다시 켠 뒤의 전환 구간이 시계열에 들어가야 하므로 2주짜리 짧은 실험으로는 부족할 수 있다. 포화를 식별하려면 지출 수준이 다른 실험이 여러 번 필요하다. 논문은 사전 4주, 실험 4주, 회복 8주로 구성된 실험 네 번을 썼다.
참고자료
- [1]Niklas Heusch, "Structural Estimation of Marketing Mix Model Parameters from Geo-Experiments", arXiv:2608.21128 v2 (2026-09)
- [2]Niklas Heusch, "A Synthetic Benchmark Dataset with Endogenous Marketing Spend for Validating Marketing Mix Models", arXiv:2608.21130 (2026-08)
- [3]Yingxiang Zhang, Mike Wurm, Eddie Li, Alexander Wakim, Joseph Kelly, Brenda Price, Ying Liu, "Media Mix Model Calibration With Bayesian Priors", Google (2024-01)
- [4]Ryan Dew, Nicolas Padilla, Anya Shchetkina, "Your MMM is Broken: Identification of Nonlinear and Time-varying Effects in Marketing Mix Models", arXiv:2408.07678 (2024-08)
- [5]Brett R. Gordon, Florian Zettelmeyer, Neha Bhargava, Dan Chapsky, "A Comparison of Approaches to Advertising Measurement: Evidence from Big Field Experiments at Facebook", Marketing Science 38(2) (2019)
- [6]Juan Camilo Orduz, "Lift Test Calibration", PyMC-Marketing 문서 (2024)
요약
- 광고 예산은 수요를 따라 움직이기 때문에 관측 데이터만 쓰는 MMM은 상관을 효과로 읽는다. 합성 데이터에서 실제 ROAS 4.20배를 10.66배로 추정했다.
- 실제 교란 요인을 전부 넣은 모델도 8.45배였다. 통제 변수를 늘리는 것으로는 고쳐지지 않았다.
- 처치 지역과 대조 지역의 매출을 빼면 계절성, 다른 채널, 관측되지 않는 수요가 모두 사라지고 이월·포화·효과 크기 세 파라미터만 남는다.
- 실험 네 번을 쌓은 구조 추정은 4.14배(90% 구간 3.77에서 4.51)로 참값을 구간 안에 넣었다. 근거는 합성 데이터이고, 실험이 훑은 지출 범위 밖에서는 반응 곡선이 식별되지 않는다.
이 글의 주제를 우리 브랜드로 확인해 보세요
고객의 한국어 질문에 ChatGPT·Perplexity가 어떻게 답하는지 측정하고 빠진 자리를 찾아 고치는 TRAIL Search가 이 글의 내용을 진단으로 이어 줍니다. 카드 없이 질문 10개로 시작합니다.
이 글의 주제와 직접 닿는 기능은 자사 가시성 추적입니다.
다른 글
LLM 추천 시스템의 콜드 스타트를 지식그래프 RAG로 푼다
LLM 추천 시스템이 질문마다 지식그래프 검색량을 스스로 고르게 한 KDD 2026 연구를 정리했다. 콜드 스타트 정확도가 0.39에서 0.50으로 올랐고, 응답 시간은 절반 이하로 줄었다.
RAG 성능은 검색 최적화보다 답변 검증에서 더 오른다
RAG 기능 4종의 16개 조합을 768개 응답으로 비교한 실험에서, 생성한 답의 빠진 측면을 확인하는 완결성 검사 하나가 검색 기능 세 개를 함께 켠 구성보다 품질이 높았다. 지연은 두 배가 됐다.
AI 에이전트는 언제 웹 검색을 할지 이미 알고 있다
LLM 에이전트는 웹 검색 같은 도구가 필요한지를 답을 쓰기 전 은닉 상태에 이미 담고 있다(AUROC 0.89에서 0.96). 이 신호로 도구 호출을 48% 줄인 UCSD 연구를 정리했다.
같은 주제로 이어 읽기
- 생성형 검색은 전통 검색과 다른 사이트를 인용한다구글 검색, AI 오버뷰, 제미나이가 같은 질문에 인용하는 출처는 평균 18%만 겹쳤다. AI 오버뷰는 실제 질문의 51.5%에 뜨고, AI 크롤러를 막은 매체는 인용에서 밀려난다. SIGIR 2026 연구를 정리했다.
- AI 검색은 이름은 알아도 신제품은 추천하지 않는다AI는 이름을 물으면 제품을 99% 알아보지만 '좋은 신제품 추천해줘'에는 3%만 등장한다. Product Hunt 스타트업 112개를 2,240개 질문으로 잰 2025년 연구를 읽고, GEO 점수가 왜 신제품 노출을 못 높였는지 정리했다.
- GEO 효과를 매출로 재는 법: AI 답변 노출을 마케팅 믹스 모델에 넣기GEO가 매출에 준 효과를 재려면 AI 답변의 브랜드 등장 확률을 질문 수, 엔진 점유율, 인지 확률과 곱해 시장별 노출로 바꾼 뒤 MMM에 넣어야 한다. 2026년 GMMM 논문을 원문 수치로 정리했다.
이 글은 Papers 카테고리에 속해요. 같은 카테고리 글 44편을 한자리에서 볼 수 있어요. Papers 카테고리 글 전체 보기