GEO-16 인용 신호 프레임워크: AI가 인용하는 페이지의 특징
16개 품질 신호로 AI 답변 엔진의 인용 행동을 측정하다
AI 답변 엔진이 어떤 페이지를 인용하는지 16개 신호로 측정한 실증이에요. 구조화 데이터와 시맨틱 HTML의 영향, Perplexity와 Google의 인용 기준 차이, 점수 기준을 정리했어요.
GEO-16은 AI 답변 엔진(Brave·구글 AI 개요·Perplexity)이 어떤 웹페이지를 인용하는지를 16개 품질 신호로 채점해, 인용 가능성을 하나의 점수로 정량화한 실증 연구예요. 무엇이 AI 인용을 부르는지 GEO 원전이 본문 수사 관점에서 봤다면, 이 논문은 페이지의 구조·메타데이터·스키마 같은 온페이지 신호를 대규모로 감사해 답을 찾아요 [1].
생성형 검색이 답을 만들 때, 우리 페이지가 그 근거로 인용되려면 무엇이 갖춰져야 할까요. 막연히 "좋은 콘텐츠"를 넘어, 기계가 읽고 신뢰할 수 있는 신호가 페이지에 있어야 해요. 이 연구는 16개 B2B SaaS 버티컬의 70개 프롬프트로 1,100개 URL·1,702건의 인용을 감사해, 그 신호를 숫자로 정리했어요 [1].
GEO-16, 인용 가능성을 16개 신호로 채점한다
각 페이지는 16개 pillar(신호)에서 0–3점 밴드로 채점돼요. 밴드가 2 이상이면 그 신호를 '충족(hit)'한 것으로 봐요. 16개 신호를 합산하면 0에서 1 사이의 GEO 점수 가 나와요 [1].
16개 신호는 사람 중심 콘텐츠, 구조화 데이터, 출처, 최신성, 리스크 관리, RAG 적합성이라는 여섯 원칙으로 묶여요. 페이지가 잘 쓰였는지를 넘어, 그 품질을 기계가 읽을 수 있게 드러냈는지를 봐요 [1].
무엇이 인용을 부르나
인용 확률과 가장 강하게 연관된 신호는 기계가독 구조와 최신성이었어요. 통계·출처 같은 근거가 뒤를 이었고요 [1].
| 신호(pillar) | 상관 r | 인용 임팩트 |
|---|---|---|
| 메타데이터·최신성 | 0.68 | +47% |
| 시맨틱 HTML | 0.65 | +42% |
| 구조화 데이터 | 0.63 | +39% |
| 근거·인용 | 0.61 | +37% |
| 권위·신뢰 | 0.59 | +35% |
| 내부 링크 | 0.57 | +33% |
표 1. 인용 확률을 가장 크게 올리는 신호(모두 p < 0.001) [1].
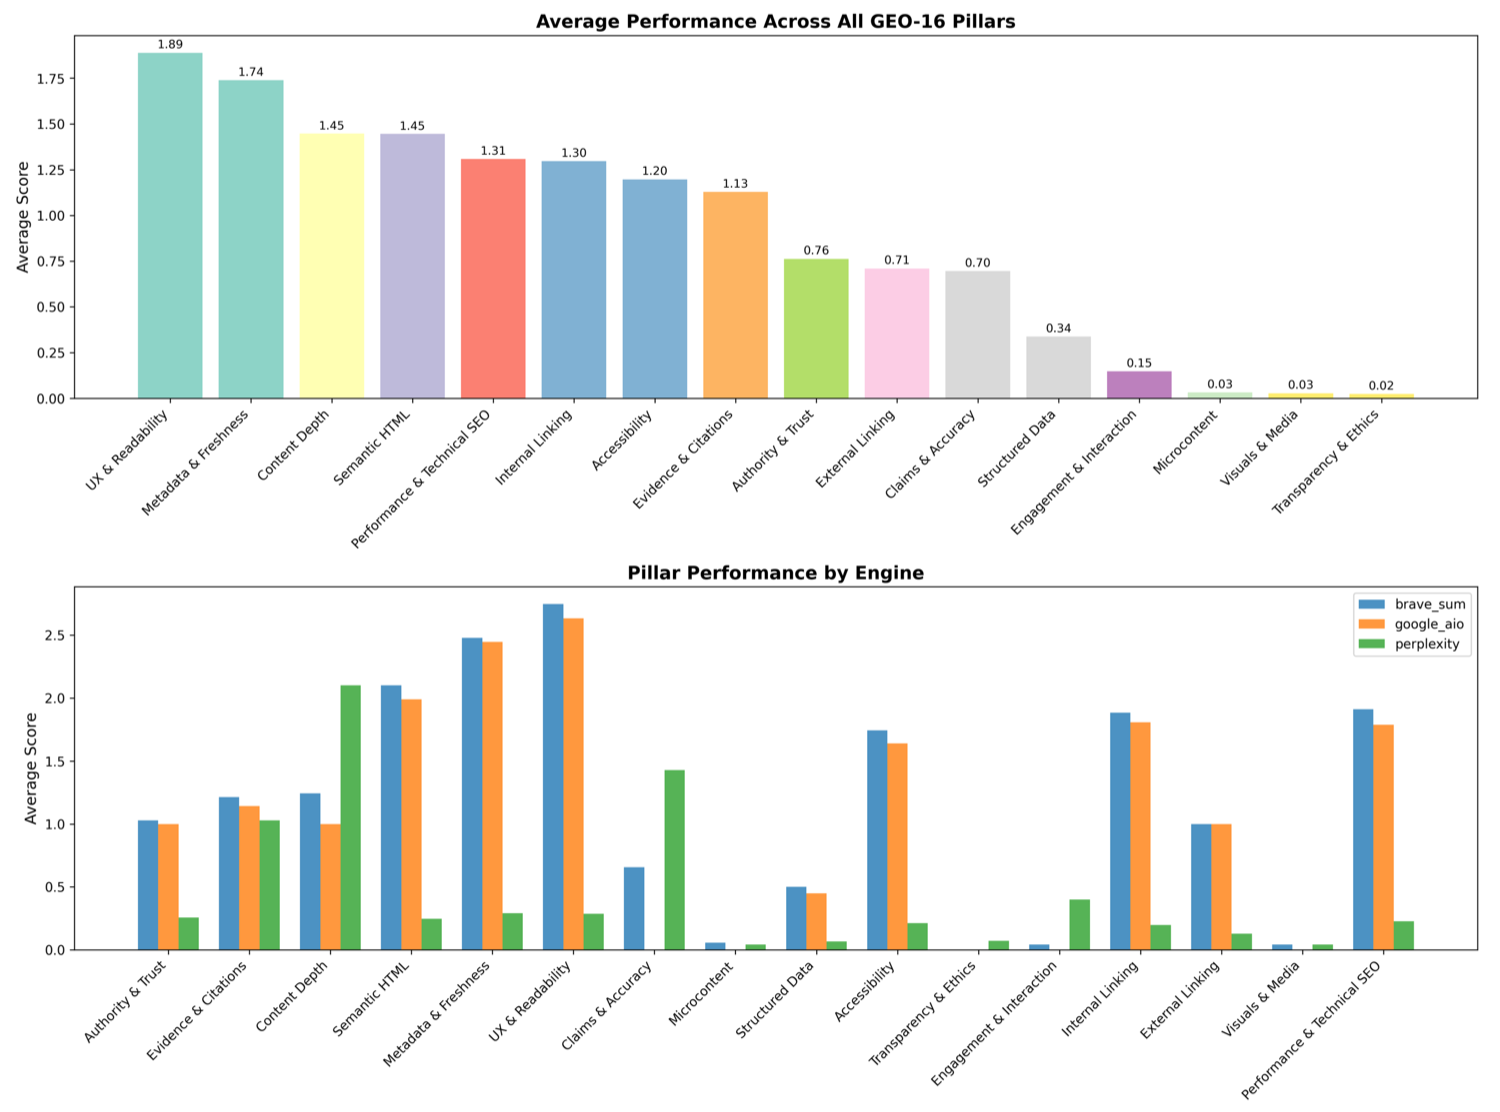
그림 1. 신호별 평균 점수. 가독성·메타데이터·최신성이 상위, 투명성·미디어가 하위를 차지한다.
즉 사람이 읽는 게시·수정일과 JSON-LD의 날짜를 함께 노출하고, 페이지당 단일 H1에 논리적 소제목 위계를 세우고, 유효한 스키마(Article·FAQPage 등)를 다는 것이 가장 큰 지렛대예요. 구글도 구조화 데이터의 역할을 공식 안내하고 있어요 [3]. 반대로 스키마가 가시 콘텐츠와 어긋나면 효과가 사라져요 [1].
어느 정도면 '잘 인용되는' 페이지일까
논문은 운영에 쓸 임계점을 제시해요. GEO 점수가 0.70 이상이고 충족 신호가 12개 이상이면, 세 엔진에 걸친 인용률이 78%로 뛰었어요. 로지스틱 회귀(Nagelkerke = 0.743)에서 GEO 점수의 승산비(OR)는 4.2로, 어떤 요인보다 컸어요 [1].
| 기준 | 민감도 | 특이도 | Youden's J |
|---|---|---|---|
| G ≥ 0.70 | 0.78 | 0.84 | 0.62 |
| 충족 신호 ≥ 12 | 0.85 | 0.79 | 0.64 |
표 2. 인용 여부를 가르는 운영 임계점 [1]. 두 조건을 함께 만족하면 교차 인용률 78%.
특히 두 엔진 이상이 함께 인용한 URL은 한 엔진만 인용한 URL보다 품질 점수가 71% 높았어요. 교차 인용은 품질의 강한 신호예요 [1].
엔진마다 문턱이 다르다
같은 페이지도 엔진마다 대접이 달라요. Brave는 가장 까다로워 고품질·고구조 페이지만 인용했고, Perplexity는 문턱이 낮아 저구조 페이지도 폭넓게 인용했어요 [1].
| 엔진 | 평균 GEO | 평균 충족 신호 | 인용률 |
|---|---|---|---|
| Brave Summary | 0.727 | 11.6 | 78% |
| 구글 AI 개요 | 0.687 | 11.0 | 72% |
| Perplexity | 0.300 | 4.8 | 45% |
표 3. 엔진별 인용 성향. Brave·구글은 구조를 크게 보상하고, Perplexity는 문턱이 낮다 [1].
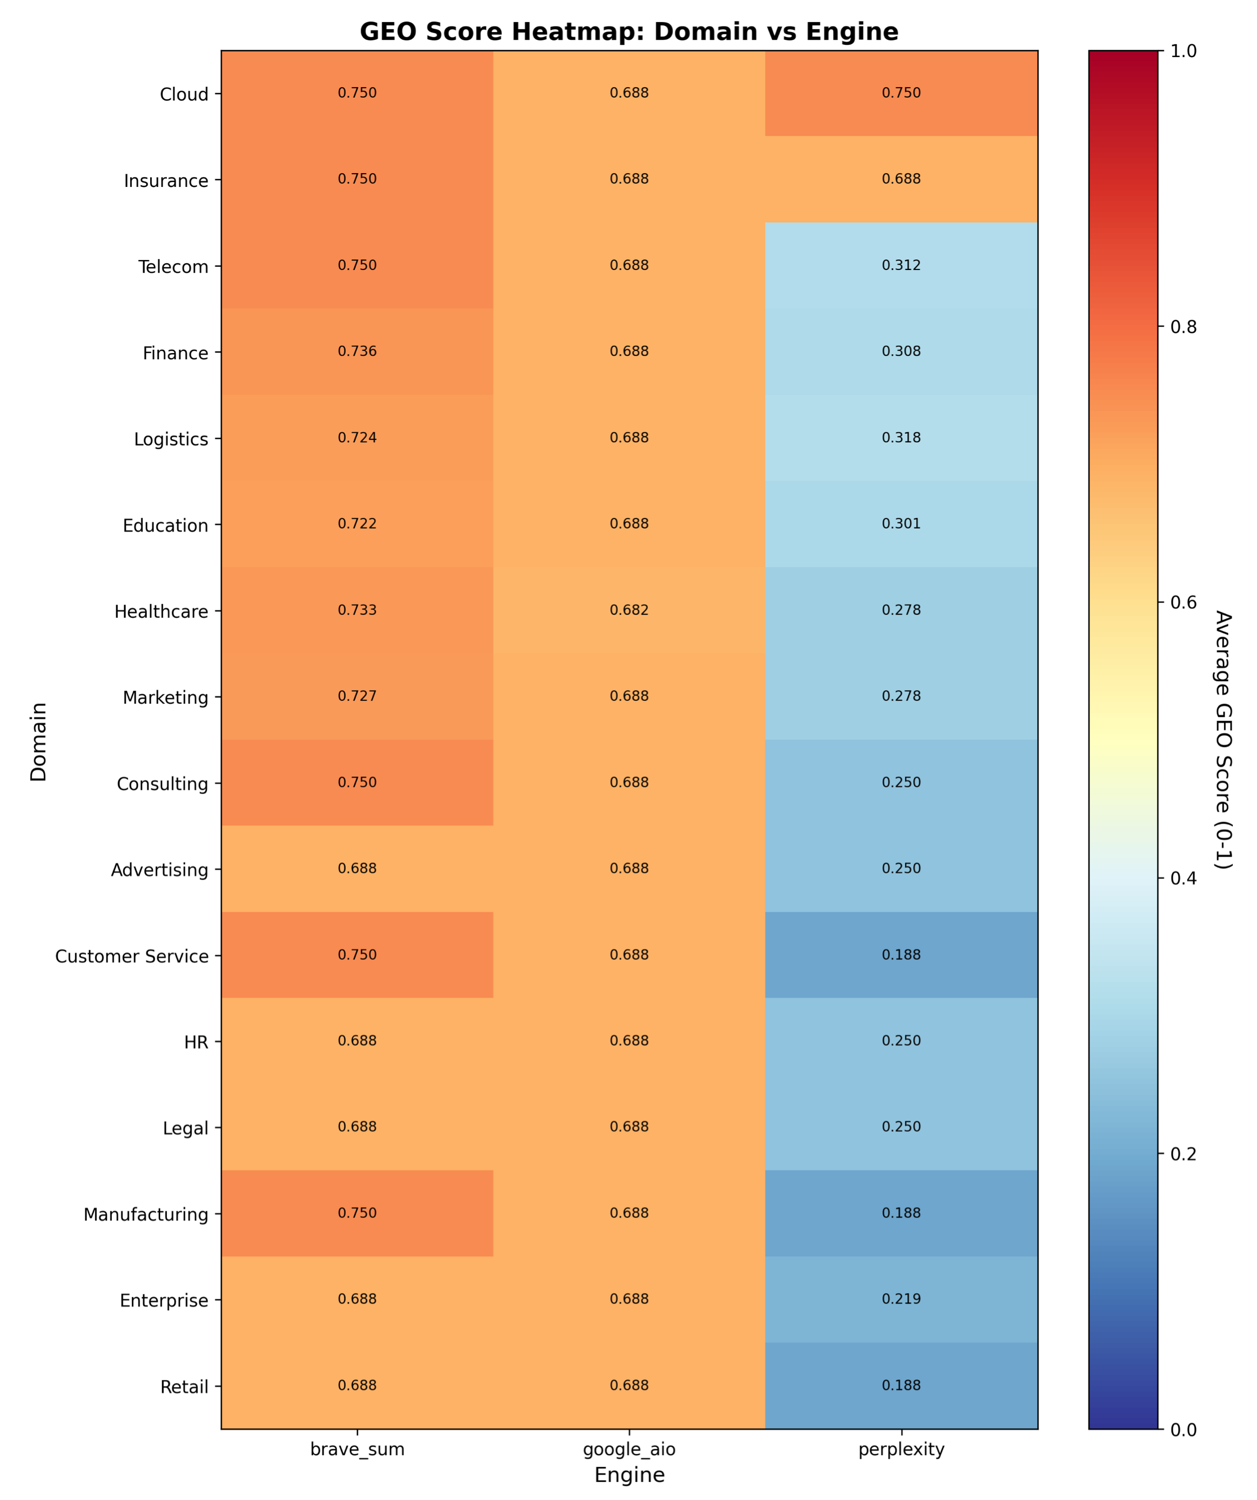
그림 2. 도메인·엔진별 GEO 점수 분포. Brave가 일관되게 가장 높은 문턱을 보인다.
그래서 우선순위가 갈려요. Brave·구글 AI 개요를 노린다면 구조·스키마·최신성에 집중하는 게 ROI가 크고, Perplexity는 온페이지 구조 가중치가 약해서 구조 최적화만으로는 부족해요.
이 연구의 한계
한 가지 주의할 점이 있어요. 이 감사는 영어·B2B SaaS·단일 시점의 관찰적 연구라, 인과가 아닌 상관이에요. 백링크·브랜드 평판 같은 오프페이지 요인은 재지 않았고요 [1]. 실제로 고품질 페이지라도 벤더 블로그에만 있으면 인용이 약했는데, 생성 엔진이 제3자 권위 도메인을 선호하기 때문이에요.
TRAIL 관점: 구조를 점수로 관리한다
이 연구는 우리가 하는 일을 그대로 뒷받침해요. AEO·GEO의 성과는 'AI가 우리를 인용했나'이고, TRAIL Search는 그 인용·점유율(SoV)을 엔진별로 추적해요. GEO-16의 교훈을 실무 체크리스트로 옮기면 이래요.
- 메타데이터·최신성 먼저: 가시 날짜와 JSON-LD 날짜를 함께, 실질 개정 이력을 남겨요. 기여가 가장 큰 축이에요.
- 구조를 세워요: 단일 H1·논리적 소제목·유효 스키마로 기계가독 단서를 갖춰요. 스키마는 본문과 일치시켜요.
- 근거를 촘촘히: 1차 출처 인용과 통계로 인용 가능한 단위를 늘려요.
- 엔진별로 다르게: Brave·구글은 구조 보상이 크고, Perplexity는 제3자 권위 도메인 노출이 더 결정적이에요.
결국 인용은 "좋은 글"이라는 막연한 목표가 아니라, 신호별로 점수를 매겨 관리할 수 있는 문제예요. 무엇을 담을지 자동으로 최적화하는 FeatGEO와 함께 보면, 설계와 측정이 한 쌍으로 맞물려요 [4].
이 글과 이어지는 내용은 AI는 두 페이지 중 무엇을 인용할까? 경쟁 인용의 4대 게이트키퍼, 구조만 바꿔도 AI 인용이 오를까? 헤딩·문단 길이·문서 골격 실증, FeatGEO: AI 인용을 만드는 건 키워드일까 구조일까, 피처 단위 GEO에서 볼 수 있어요.
자주 묻는 질문
GEO-16이 뭔가요?
AI 답변 엔진이 인용할 만한 페이지인지를 16개 품질 신호(pillar)로 0–3점씩 채점해 하나의 점수 G로 합산하는 프레임워크예요. 메타데이터·최신성, 시맨틱 HTML, 구조화 데이터 같은 기계가독 신호가 핵심이에요.
인용을 가장 크게 올리는 신호는 뭔가요?
메타데이터·최신성(+47%), 시맨틱 HTML(+42%), 구조화 데이터(+39%) 순이었어요. 사람이 읽는 날짜와 JSON-LD 날짜를 함께 노출하고, 단일 H1에 논리적 소제목 위계를 세우고, 유효한 스키마를 다는 게 우선순위예요.
어느 정도면 잘 인용되나요?
논문의 운영 임계점은 G ≥ 0.70이고 hit(밴드 2 이상 신호) ≥ 12예요. 이 둘을 동시에 만족하면 세 엔진 교차 인용률이 78%였어요. 로지스틱 회귀에서 GEO 점수의 승산비(OR)는 4.2로 가장 컸어요.
엔진마다 인용 성향이 다른가요?
크게 달라요. Brave는 평균 GEO 0.727로 가장 까다로워 고품질·고구조 페이지만 인용했고, Google AI 개요가 그다음(0.687), Perplexity는 0.300으로 문턱이 훨씬 낮아 저구조 페이지도 폭넓게 인용했어요.
참고자료
요약
- GEO-16은 AI 답변 엔진이 인용할 페이지인지를 16개 신호로 채점해 점수 G로 합산하는 실증 프레임워크예요.
- 메타데이터·최신성, 시맨틱 HTML, 구조화 데이터 같은 기계가독 구조 신호가 인용과 가장 강하게 연관됐어요(각 +47%·+42%·+39%).
- 운영 임계점은 G ≥ 0.70 + 신호 12개 이상, 이때 세 엔진 교차 인용률이 78%였고 GEO 점수의 승산비는 4.2였어요.
- Brave·Google은 구조를 크게 보상하고 Perplexity는 문턱이 낮아, 엔진별로 최적화 우선순위가 달라야 해요.
- 고품질 페이지라도 벤더 블로그에만 있으면 인용이 약해서, 온페이지 구조와 제3자 권위 도메인 노출을 함께 챙겨야 해요.
이 글의 주제를 우리 브랜드로 확인해 보세요
고객의 한국어 질문에 ChatGPT·Perplexity가 어떻게 답하는지 측정하고 빠진 자리를 찾아 고치는 TRAIL Search가 이 글의 내용을 진단으로 이어 줍니다. 카드 없이 질문 10개로 시작합니다.
이 글의 주제와 직접 닿는 기능은 AEO·GEO 검수입니다.
다른 글
지역 실험으로 마케팅 믹스 모델 보정하는 법: ROAS 숫자 하나 대신 시계열 전체를 쓴다
지역 실험으로 마케팅 믹스 모델을 보정할 때 ROAS 숫자 하나만 쓰면 이월과 포화 정보가 버려진다. 처치·대조 차분식으로 세 파라미터를 추정해 MMM의 ROAS 과대추정을 바로잡은 2026년 논문을 원문 수치로 정리했다.
LLM 추천 시스템의 콜드 스타트를 지식그래프 RAG로 푼다
LLM 추천 시스템이 질문마다 지식그래프 검색량을 스스로 고르게 한 KDD 2026 연구를 정리했다. 콜드 스타트 정확도가 0.39에서 0.50으로 올랐고, 응답 시간은 절반 이하로 줄었다.
RAG 성능은 검색 최적화보다 답변 검증에서 더 오른다
RAG 기능 4종의 16개 조합을 768개 응답으로 비교한 실험에서, 생성한 답의 빠진 측면을 확인하는 완결성 검사 하나가 검색 기능 세 개를 함께 켠 구성보다 품질이 높았다. 지연은 두 배가 됐다.
같은 주제로 이어 읽기
- AI 에이전트는 언제 웹 검색을 할지 이미 알고 있다LLM 에이전트는 웹 검색 같은 도구가 필요한지를 답을 쓰기 전 은닉 상태에 이미 담고 있다(AUROC 0.89에서 0.96). 이 신호로 도구 호출을 48% 줄인 UCSD 연구를 정리했다.
- 생성형 검색은 전통 검색과 다른 사이트를 인용한다구글 검색, AI 오버뷰, 제미나이가 같은 질문에 인용하는 출처는 평균 18%만 겹쳤다. AI 오버뷰는 실제 질문의 51.5%에 뜨고, AI 크롤러를 막은 매체는 인용에서 밀려난다. SIGIR 2026 연구를 정리했다.
- AI 검색은 이름은 알아도 신제품은 추천하지 않는다AI는 이름을 물으면 제품을 99% 알아보지만 '좋은 신제품 추천해줘'에는 3%만 등장한다. Product Hunt 스타트업 112개를 2,240개 질문으로 잰 2025년 연구를 읽고, GEO 점수가 왜 신제품 노출을 못 높였는지 정리했다.
이 글은 Papers 카테고리에 속해요. 같은 카테고리 글 44편을 한자리에서 볼 수 있어요. Papers 카테고리 글 전체 보기