LLM 에이전트 비용 줄이는 법: 결정을 4B 모델에 맡기면 81–89% 절감
작은 모델로 AI 에이전트를 돌리는 세 번째 방법, JevAgentHarness. 에이전트가 느리고 비싼 이유와, 평가를 고립 질문으로 하면 틀리는 지점
LLM 에이전트 비용을 줄이는 결정 위임 연구를 정리했어요. 고립 질문 정확도는 루프 성공을 예측하지 못하고, 신뢰도 임계값을 에이전트 자신의 궤적으로 맞출 때만 비용 81–89% 절감이 성공 손실 없이 나왔어요.
LLM 에이전트의 스텝 대부분은 객관식 결정이고, 그 결정을 작은 결정 모델에 신뢰도 임계값으로 위임하면 과제 성공을 3점 이내로 지키면서 비용을 81.1에서 89.0% 줄일 수 있다는 것이 UIUC, Princeton, Google 연구진의 JevAgentHarness 논문[1] 결과예요. 단서가 둘 붙어요. 고립 질문 정확도가 가장 높은 모델이 실제 에이전트 과제는 69.5%만 풀었고, 임계값을 맞추지 않은 위임은 성공률을 19.0점 깎았어요. 위임은 공짜가 아니라 조건부예요.
이 글은 2026년 11월 기준 arXiv v1 원문 PDF를 직접 읽고 공개 모델 카드[2]와 대조해 정리했어요. 저자들은 등록한 11개 가설을 Holm 보정으로 검정했고, 성공 유지 주장은 비열등성 검정(마진 3점, τ²-bench는 5점) 기준이에요. 아직 동료평가 전 프리프린트이고, 우리는 다단계 LLM 파이프라인을 운영하는 회사라 이 주제에 이해관계가 있어요.
문제: 에이전트가 느리고 비싼 이유
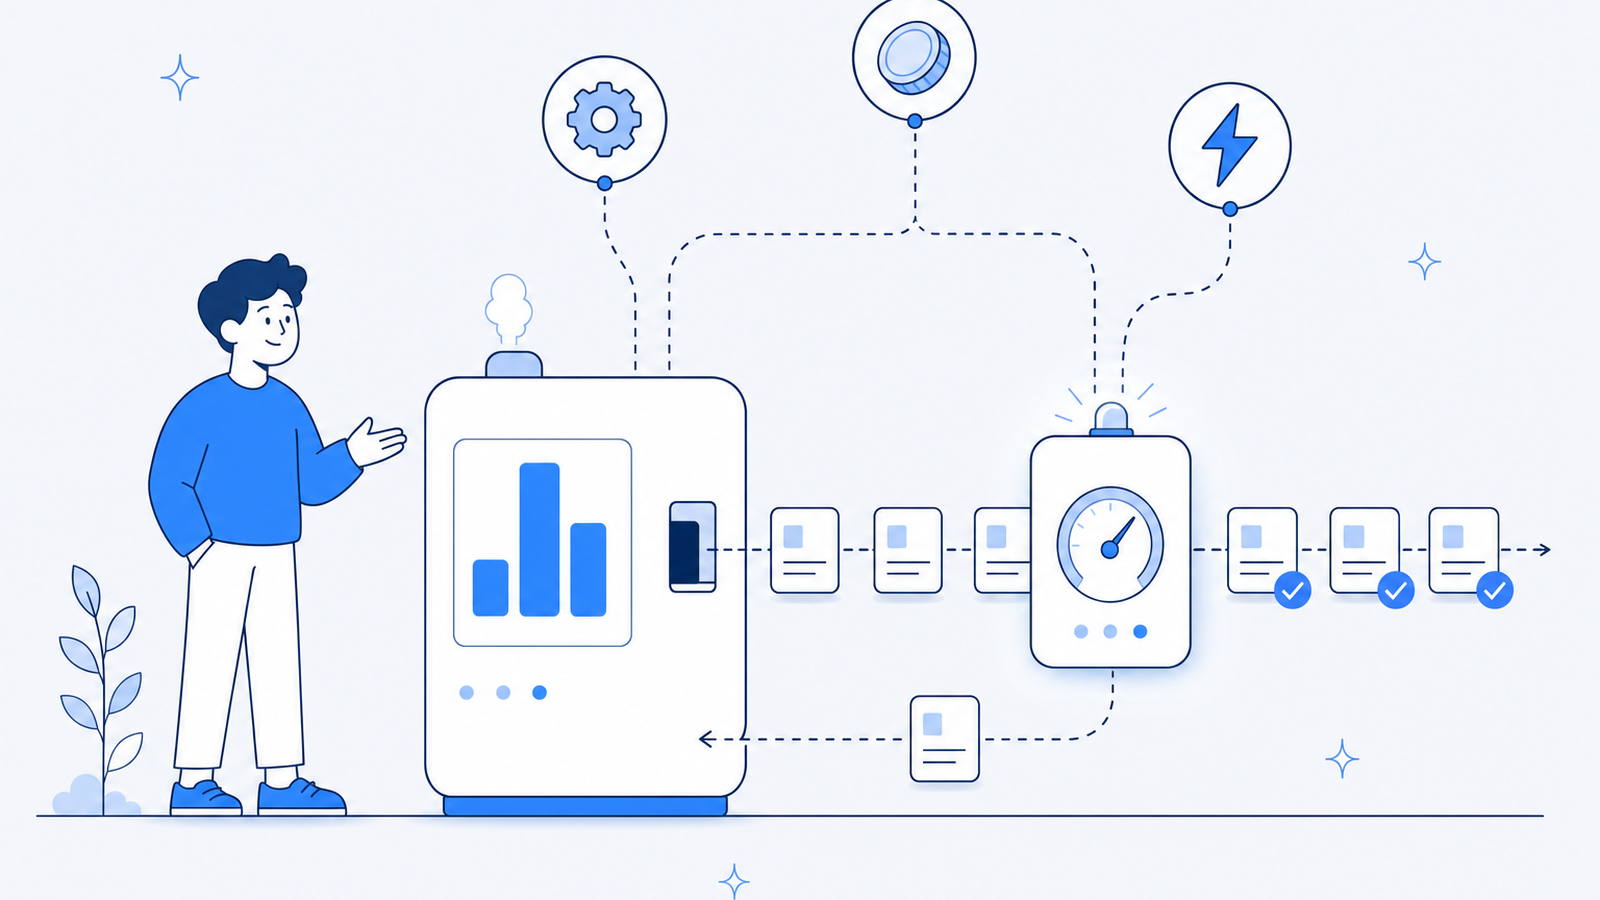
에이전트 하니스는 매 스텝 큰 LLM을 호출해요. 어느 툴을 부를지, 인자는 무엇으로 할지, 과제가 끝났는지. 긴 과제일수록 이 호출이 쌓여 느려지고 비싸져요. 그런데 이 스텝의 대부분은 선택지가 나열된 객관식이에요[1].
결정 모델은 이 질문에 텍스트 생성 없이 옵션별 확률만 돌려줘요. 논문이 기록한 한 에피소드에서 결정 모델 Jev 호출은 LLM 호출 시간의 28%, 가격의 2.6%였어요[1]. 빠르고 직관적인 System 1에 결정을 맡기고, 느리고 신중한 System 2는 필요할 때만 부른다는 구도예요.
상태 에서 결정 모델이 옵션 마다 확률을 매기고, 최고 확률이 임계값 를 넘을 때만 그 답을 쓰고, 못 넘으면 LLM이 결정해요. 이 논문의 기여는 를 어디서 얻는가에 있어요.
3층 평가: 고립 질문에서 실행 중 에이전트까지
저자들은 결정 모델을 평가하는 AgentDecisionBench를 3층으로 만들었어요[1].
| 층 | 무엇을 재나 | 조건 |
|---|---|---|
| L1 | 고립 질문 정확도 | 에이전트 없이 단일 질문 |
| L2 | 스텝 수준 정확도 | 기록된 에이전트 런 위에서 |
| L3 | 과제 수준 성공률 | 실행 중인 에이전트의 결정을 실제로 제어 |
표 1. AgentDecisionBench의 3층 구조. 층이 올라갈수록 결정의 결과가 다음 상태에 반영돼요[1].
대상 환경은 τ²-bench, ALFWorld, 자체 제작 DecisionGym이고, 훅을 붙여 mini-SWE-agent와 SWE-agent(SWE-bench Verified), Codex CLI, Claude Code 같은 기존 하니스도 코드 수정 없이 테스트했어요(공개 저장소[3]). 에이전트 LLM은 대부분 Gemini 3.5 Flash예요.
핵심 발견: 고립 정확도는 루프 성공을 예측하지 못한다
L1에서 가장 정확한 결정 모델이 L3 과제는 69.5%만 해결했어요[1]. 그리고 임계값 없이 툴 선택을 통째로 위임하면 과제 성공이 19.0점 떨어졌어요.
이유는 결정이 순차적이라는 데 있어요. 에이전트의 한 번의 오선택은 틀린 답 하나로 끝나지 않고, 다음 결정이 보게 될 상태 자체를 바꿔요. 고립 질문은 이 연쇄를 못 재요. 구성요소를 따로 재면 잘 보이는데 루프 안에 넣으면 무너지는 패턴은, 에이전트 메모리가 벤치마크 점수와 달리 실전에서 세금을 내는 문제에서 본 것과 같은 구조예요.
하니스: 임계값을 에이전트 자신의 궤적으로 맞춘다
JevAgentHarness는 결정 모델을 shadow mode로 돌려요. 에이전트는 평소대로 LLM이 결정하게 두고, 결정 모델은 모든 결정 지점에서 조용히 답만 기록해요. 그 궤적으로 결정 지점마다 임계값을 따로 적합하고, 운영에서는 임계값을 넘는 결정만 위임해요[1].
공개된 적합값이 조건의 성격을 잘 보여줘요. 모델 카드[2] 기준 툴 선택 임계값은 0.445인데 인자 선택은 0.996이에요. 인자는 거의 확신할 때만 맡긴다는 뜻이에요. 그리고 이 값들은 Gemini 3.5 Flash를 에이전트 LLM으로 쓸 때의 값이라, 에이전트가 바뀌면 다시 맞춰야 해요.
AgentDecision-4B: 실수한 뒤의 상태까지 학습한다
기존 결정 모델의 맹점이 하나 더 있어요. 에이전트가 실수한 뒤에 도달하는 상태를 학습에서 본 적이 없다는 점이에요. 저자들은 에이전트가 실제로 도달한 상태(실수 후 상태 포함)를 모으고 Jev의 답을 라벨 삼아 4B 모델을 LoRA(r=32, 2 epochs)로 미세조정했어요[1].
| 평가 | AgentDecision-4B | 교사(Jev) |
|---|---|---|
| 학습 분포와 다른(shifted) 과제 200개, 모든 툴 선택 제어 | 91.5% | 82.0% |
| DecisionGym 신규 과제, 비용 | 86.3% 절감, 2.5배 속도 | 기준 |
| ALFWorld 전용 학습 시 | 89.0% 절감 | 기준 |
표 2. AgentDecision-4B의 과제 성공률과 비용 절감. 절감률은 해당 벤치마크와 서빙 조건의 값이에요[1][2].
4B 학생이 분포 밖 과제에서 교사를 9.5점 앞선 게 이 논문[1]에서 가장 반직관적인 결과예요. 저자들의 설명은 학습 데이터의 차이예요. 교사는 일반 질문에 강하지만, 학생은 이 에이전트가 실제로 빠지는 구덩이 근처의 상태를 집중적으로 봤어요.
한계
- benign 상태만 다뤘어요. 적대적 입력이 만드는 상태는 검증 밖이고, 저자들은 싼 에이전트 제어가 오남용의 비용도 낮춘다는 점을 명시했어요.
- 영어 과제 전용이고 에이전트 LLM은 대부분 Gemini 계열이에요.
- 임계값과 학습 모두 특정 에이전트의 런에 맞춰져 있어서, 새 에이전트, 새 툴, 새 과제군이면 재적합과 재학습이 필요해요.
- 코딩 에이전트처럼 액션이 자유 텍스트면 객관식 위임이 성립하지 않아 어느 LLM이 쓸지 고르는 역할만 가능했고, 절감은 7.0에서 10.5%로 작았어요.
- RouteLLM 같은 학습 라우터와 같은 과제 비교는 없고, 가격과 지연은 저자 환경의 기록값이에요.
실무 함의: 작은 모델로 AI 에이전트를 돌리는 세 번째 방법
이 논문은 큰 모델을 깎아 작은 모델을 만드는 Sheared-LLaMA와 오픈 웨이트로 도메인 모델을 소유하는 경로에 이어, 작은 모델을 소유하는 세 번째 경로를 보여줘요. 모델 전체를 바꾸지 않고 결정만 떼어내 위임하는 방식이고, 필요한 재료도 거대한 사전학습 코퍼스보다 자기 에이전트의 실행 기록 쪽이에요.
그리고 측정하는 입장에서 한 번 더 눈이 가는 건 평가 설계예요. 고립 정확도 1위가 루프에서는 69.5%였다는 결과[1]는, 구성요소 점수와 시스템 성과를 구분하지 않으면 정반대 결론이 나온다는 이야기예요. AI 검색 가시성에서 검색 풀 진입과 최종 인용이 갈라지는 것을 따로 재야 하는 이유와 같은 원리이고, 결국 어느 영역이든 자기 루프 안에서 잰 숫자만 믿을 수 있어요.
이 글과 이어지는 내용은 MMDocRAG, 멀티모달 문서 RAG 벤치마크에서 AI는 근거를 잘 고를까에서 이어져요.
자주 묻는 질문
결정 모델이 LLM 라우터와 뭐가 다른가요?
라우터는 요청을 어느 LLM에 보낼지 고르는 모델이고, 결정 모델은 에이전트의 객관식 선택지 자체에 옵션별 확률로 답해요. 이 논문의 하니스는 결정 모델이 확신할 때만 그 답을 쓰고 나머지는 LLM에 돌려보내는 구조라, 요청 단위 라우팅보다 결이 잘아요. 다만 저자들은 RouteLLM 같은 학습 라우터와 같은 과제에서 비교하지는 못했다고 밝혔어요.
우리 에이전트에 바로 적용할 수 있나요?
임계값과 학습이 특정 에이전트의 실행 기록에 맞춰져 있어서, 새 에이전트나 새 툴 구성이면 shadow mode로 궤적을 모아 임계값을 다시 맞춰야 해요. 공개된 임계값도 Gemini 3.5 Flash 에이전트 기준이라 다른 LLM이면 재적합이 필요해요.
코딩 에이전트에도 효과가 있나요?
제한적이에요. 코딩 에이전트는 액션이 자유 텍스트라 결정 모델이 고를 객관식 선택지가 없고, 어느 LLM이 다음 스텝을 쓸지 고르는 역할만 가능했어요. 그 구성의 절감은 7.0에서 10.5%로 작았고, 파일만 읽는 스텝을 싼 LLM에 보내는 시도는 신뢰할 만한 절감이 없었어요.
참고자료
- [1]Kunlun Zhu, Tao Feng, Xu Han, Heng Wang, Ling Yang, Xiangru Tang, Jiaxuan You, Heng Ji, "JevAgentHarness: Benchmarking, Deploying and Training Decision Models That Share Control with LLMs", UIUC·Princeton·Google, arXiv 2610.21412 (2026-10-15)
- [2]JevAgentHarness/AgentDecision-4B 모델 카드, Hugging Face (2026)
- [3]JevAgentHarness 공개 저장소 (하니스·벤치마크·학습 데이터)
요약
- 에이전트 스텝 대부분은 다음 툴, 인자, 종료 여부 같은 객관식 결정이고, 결정 모델 호출은 한 기록에서 LLM 호출 시간의 28%, 가격의 2.6%였어요.
- 고립 질문에서 가장 정확한 결정 모델이 실제 에이전트 과제는 69.5%만 풀었고, 임계값 없이 툴 선택을 위임하면 성공률이 19.0점 떨어졌어요.
- 결정 지점별 신뢰도 임계값을 에이전트 자신의 shadow mode 궤적으로 맞추고, 실수 후 도달 상태까지 학습한 4B 모델이 분포 밖 과제에서 교사 모델을 9.5점 앞섰어요.
- 유사 분포 과제에서 비용 81.1에서 89.0% 절감, 최대 2.5배 속도, 과제 성공은 3점 이내 손실이었어요.
이 글의 주제를 우리 브랜드로 확인해 보세요
고객의 한국어 질문에 ChatGPT·Perplexity가 어떻게 답하는지 측정하고 빠진 자리를 찾아 고치는 TRAIL Search가 이 글의 내용을 진단으로 이어 줍니다. 카드 없이 질문 10개로 시작합니다.
다른 글
작은 LLM을 직접 만드는 법: 3% 컴퓨트로 깎는 Sheared-LLaMA
작은 LLM을 직접 만드는 방법, LLM 프루닝이란 무엇인지, AI 에이전트에 작은 모델로 충분한지, sLLM 구축 비용의 기준선을 Sheared-LLaMA 논문으로 확인한다.
영상으로 로봇을 학습시키는 월드 모델: V-JEPA 2
영상만 보고 로봇을 학습시킬 수 있는지, AI 월드 모델이 무엇인지, 영상 생성 모델과 어떻게 다른지를 Meta의 V-JEPA 2 논문으로 정리했어요.
AI 검색은 사용자 질문을 그대로 검색할까: Perplexity 검색어 7만 개가 보여 준 것
AI 검색이 사용자 질문을 어떻게 검색어로 바꾸는지, 인용되지 않은 문서가 왜 무관한 문서가 아닌지, 검색 모델이 놓치는 문서를 Perplexity의 Q2D-Web 논문으로 정리했어요.
같은 주제로 이어 읽기
- 에이전트 메모리는 원본 대화를 그대로 검색하는 RAG보다 나을까에이전트 메모리 시스템이 원본을 검색하는 RAG보다 못한 이유, LLM 요약이 잃는 정보, 원본 복구 경로로 손실을 줄이는 방법을 정리한 2026년 UIUC 연구 해설이에요.
- RAG 답변은 왜 필요한 근거를 다 가져오지 못할까RAG가 멀티팩트 질문에서 근거를 일부만 가져오는 이유, 청킹이 문서 정체성을 지우는 문제, 답과 인용을 함께 채점하면 드러나는 실패를 정리한 2026년 MBZUAI 연구 해설이에요.
- AI 검색 답변은 사용자 위치에 따라 출처가 달라질까사용자 위치가 ChatGPT·Gemini의 인용 출처와 추천 업체를 어떻게 바꾸는지, 위치 신호가 어느 경로로 들어가는지 답변 31,200개로 잰 2026년 Toronto 대학 연구를 정리했어요.
이 글은 Papers 카테고리에 속해요. 같은 카테고리 글 36편을 한자리에서 볼 수 있어요. Papers 카테고리 글 전체 보기