콘텐츠 중심 GEO(CC-GSEO): AI 에이전트 자동 재작성으로 인용 늘리기
한 글이 여러 질의에 미치는 영향력을 에이전트로 끌어올리기
키워드 최적화 대신 글 하나가 여러 관련 질문 전반에 미치는 영향력을 AI 에이전트가 자동으로 고쳐 쓰며 최적화하는 CC-GSEO예요. 재작성을 몇 번 반복해야 인용이 느는지 정리했어요.
CC-GSEO는 생성형 검색 최적화의 대상을 '키워드·순위'에서 '콘텐츠 자체'로 옮겨, 한 글이 그 주제의 여러 관련 질의 전반에 미치는 영향력을 정량화하고 에이전트로 끌어올리는 방법이에요. 생성 엔진이 순위 목록을 하나의 합성 답변으로 대체하면서, 키워드 순위를 올리는 최적화의 효력이 끊겼기 때문이에요 [1][2].
전통 SEO는 검색 결과에서의 위치를 올리는 게임이었어요. 하지만 생성 엔진은 상위 10개에 들어도 답변에 반영되지 않으면 가시성이 0이에요. 게다가 콘텐츠 제작자의 진짜 목표는 한 질의에서 한 번 인용되는 게 아니라, 글의 핵심 사실이 그 주제에 대한 사용자의 이해 전반을 형성하는 거예요. 그래서 영향력은 한 글에 묶인 여러 질의(평균 5.2개, 2–10개)에 걸쳐 재야 해요 [1].
영향력을 여섯 차원으로 쪼갠다
논문은 한 소스 글의 영향력을 서로 겹치지 않는 여섯 차원으로 분해하고, 각 차원을 LLM 심판이 0–10점으로 채점해요 [1][4].
| 층위 | 차원 | 콘텐츠에서 다듬는 것 |
|---|---|---|
| 귀속 메커닉 | 인용 명료성(CP) | 이 소스가 답변에서 얼마나 눈에 띄게 인용되나 |
| 충실도 | 귀속 정확성(AA) | 답변이 인용한 주장이 실제로 이 소스에서 나왔나 |
| 충실도 | 충실성(FA) | 원문 의미가 왜곡 없이 보존되나 |
| 의미 지배력 | 의미 기여(SC) | 글의 핵심 아이디어가 답변으로 전이되나 |
| 의미 지배력 | 핵심정보 커버리지(KC) | 글의 구체적 사실이 답변에 담기나 |
| 의미 지배력 | 답변 지배력(AD) | 답변 전체를 형성하는 데 이 글이 차지하는 비중 |
표 1. 콘텐츠 영향력의 여섯 차원 [1]. 키워드 대신 인용 가능성과 의미 지배력을 올린다.
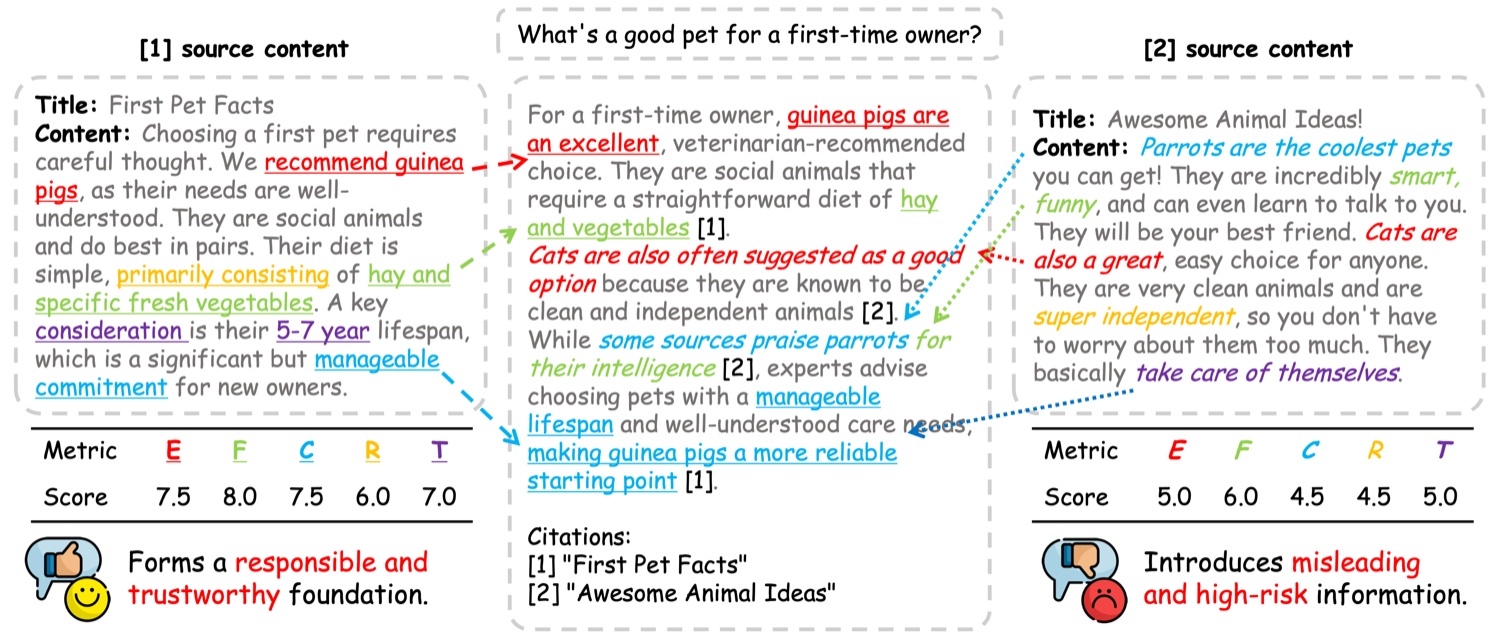
그림 1. 영향력 평가 프레임워크. 소스 글이 답변에 반영되는 정도를 여섯 차원으로 채점한다.
각 차원은 세 지표로 요약해요. 전 질의 평균 점수 , 성공 임계 를 넘은 질의 비율 , 그리고 한 글의 질의 집합 내 분산 예요. 분산이 낮을수록 다양한 질의에 고르게 인용된다는 뜻이에요 [1].
다섯 에이전트가 글을 고쳐 쓴다
핵심 장치는 MACO, 다섯 에이전트가 도는 반복 루프예요 [1].
- 질의 에이전트: 글마다 다양·관련 질의를 만들고 검색으로 맥락 문서를 모아요.
- 평가 에이전트: 각 질의에서 RAG를 시뮬레이션해 여섯 차원을 채점해요.
- 분석 에이전트: 저점수 사례로 약점을 진단하고 개선 제안을 만들어요.
- 수정 에이전트: 가장 적절한 제안으로 글을 실제로 재작성해요.
- 선택 에이전트: 전체 궤적을 훑어 성능과 일관성이 가장 좋은 버전을 골라요.
중요한 건 무한히 고치지 않는다는 점이에요. 선택 에이전트가 가장 자주 고르는 지점은 5회차 부근이고, 그 이후엔 성능이 평탄해지거나 충실성이 깎여요. 진단 없이 오래 리라이트하면 오히려 원문이 망가지는 거예요 [1].
무엇이 얼마나 좋아졌나
CC-GSEO-Bench는 1,030개 소스 글과 5,353개 질의-글 쌍으로 이뤄져요. 결과는 뚜렷했어요. 여섯 차원 모두 최강 단일 베이스라인을 앞섰고, 특히 답변을 지배하고 핵심 의미를 전이하는 차원에서 효과가 컸어요 [1].
| 차원 | 평균 점수(MIS) | 성공률(ISR) | 분산 변화(MIV) |
|---|---|---|---|
| 인용 명료성 | 7.47 (+18.6%) | 0.61 (+41.9%) | -88.7% |
| 핵심정보 커버리지 | 9.01 (+21.1%) | 0.99 (+47.8%) | -96.8% |
| 의미 기여 | 8.96 (+27.8%) | 0.99 (+62.3%) | -98.6% |
| 답변 지배력 | 8.82 (+46.5%) | 0.99 (+209%) | -97.4% |
표 2. MACO 대 최강 단일 베이스라인(발췌). 답변 지배력의 성공률이 209% 올랐다 [1].
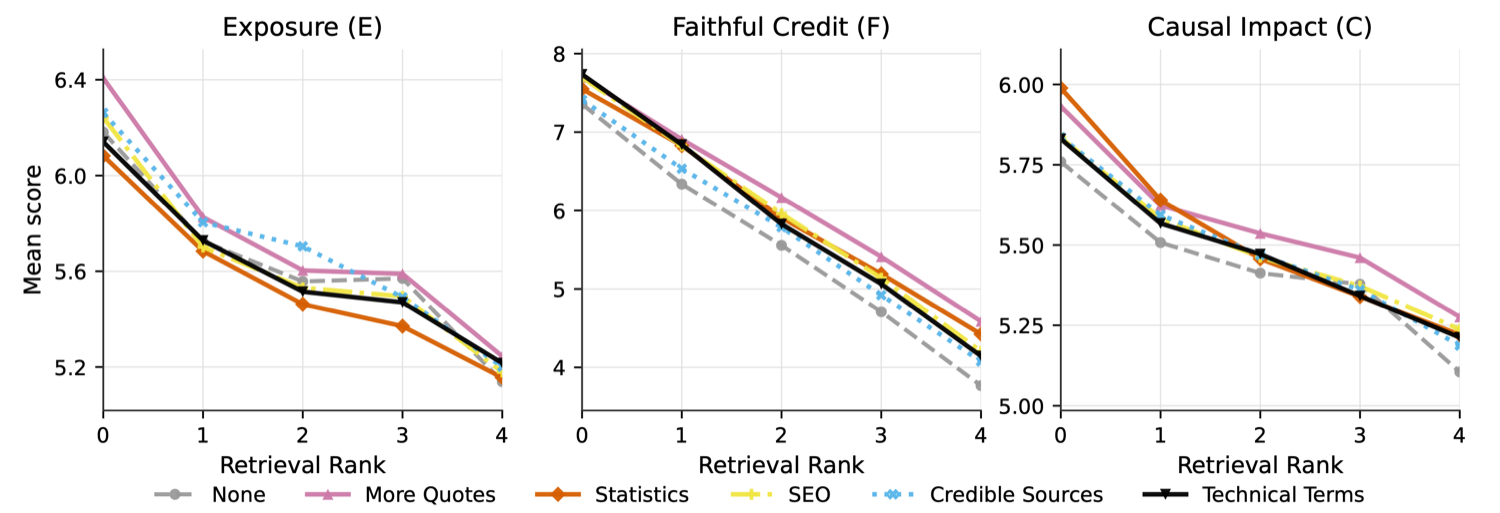
그림 2. 콘텐츠 전략별 영향력 비교. 단일 전략 중에서는 인용문 추가가 전반적으로 우세하다.
단일 전략 중에서는 인용문 추가가 여섯 중 다섯 차원에서 가장 강했어요. 하지만 인용문·전문 용어·출처·유창성 네 전략을 단순히 합쳐도(귀속 정확성 8.60), 진단 기반으로 맞춤 수정한 MACO(9.00)를 넘지 못했어요. 무엇을 더할지 진단해서 고르는 시너지가 핵심이라는 뜻이에요 [1].
TRAIL 관점: 글 하나가 주제 전반을 덮게
이 연구의 방향은 우리 일과 곧장 이어져요. AEO·GEO의 성과는 'AI가 우리를 인용했나'이고, TRAIL Search는 그 인용·점유율(SoV)을 추적해요. CC-GSEO의 교훈을 실무로 옮기면 이래요.
- 답변 지배력을 1순위로: 주제의 핵심 사실·정의·결론을 한 곳에 명확·단정적으로 담은 정답 블록을 만들어요. 가장 큰 향상이 여기서 나와요.
- 인용 가능한 단위를 늘려요: 직접 인용문·통계·출처로 인용 명료성과 귀속 정확성을 직접 올려요.
- 질의 fanout 전반을 덮어요: 한 키워드가 아니라, 그 주제에서 사용자가 물을 여러 질의를 한 글이 자기완결적으로 커버하는지 점검해요.
- 고치되 멈출 줄 알기: 진단 기반으로 다듬되 5회 안팎에서 멈춰 과최적화를 피해요.
결국 CC-GSEO는 GEO를 '키워드 손보기'에서 '콘텐츠 설계하기'로 끌어올려요. 무엇을 담을지 피처로 최적화하는 FeatGEO, 그리고 개념·지표를 세운 GEO 원전과 함께 보면, 콘텐츠 중심 최적화의 자리가 또렷해져요 [2][3].
이 글과 이어지는 내용은 AI는 두 페이지 중 무엇을 인용할까? 경쟁 인용의 4대 게이트키퍼, 구조만 바꿔도 AI 인용이 오를까? 헤딩·문단 길이·문서 골격 실증, GEO-16 인용 신호 프레임워크: AI가 인용하는 페이지의 특징에서 볼 수 있어요.
자주 묻는 질문
기존 GEO와 뭐가 다른가요?
기존 GEO는 '이 글이 이 질의 하나에서 인용되나'를 봐요. 이 논문은 최적화 대상을 키워드 대신 콘텐츠(글) 자체로 옮기고, 한 글이 그 주제의 여러 관련 질의(평균 5.2개) 전반에 미치는 영향력을 6개 차원으로 재요. 한 글이 주제 전반의 이해를 형성하는지를 보는 거예요.
영향력을 어떤 차원으로 재나요?
인용 명료성, 귀속 정확성, 충실성, 의미 기여, 핵심정보 커버리지, 답변 지배력 여섯 차원이에요. 각 차원을 LLM 심판이 0–10점으로 채점하고, 평균 점수·성공률·글 내 분산 세 지표로 요약해요.
어떻게 글을 고치나요?
평가→분석→제안→수정→반복의 5-에이전트 루프(MACO)로 글을 자동 진단하고 재작성해요. 다만 무한히 고치지 않고, 선택 에이전트가 성능과 일관성이 가장 좋은 5회차 부근 버전을 골라 과최적화를 막아요.
효과가 얼마나 되나요?
핵심 지표에서 최강 단일 베이스라인 대비 18–209% 향상됐고, 특히 답변 지배력의 성공률이 209% 올랐어요. 동시에 글 내 분산이 88–98% 줄어, 다양한 질의에 걸쳐 고르게 인용됐어요.
참고자료
요약
- CC-GSEO는 최적화 대상을 키워드 대신 콘텐츠로 옮겨, 한 글이 여러 관련 질의 전반에 미치는 영향력을 6개 차원으로 재요.
- 5-에이전트 루프(평가·분석·제안·수정·선택)로 글을 자동 진단·재작성하되, 5회차 부근에서 멈춰 과최적화를 막아요.
- 핵심 지표에서 베이스라인 대비 18–209% 향상, 특히 답변 지배력 성공률 +209%였고, 글 내 분산은 88–98% 줄었어요.
- 단일 전략 중엔 인용문 추가가 가장 강했지만, 전략을 단순 합치는 것보다 진단 기반 맞춤 수정의 시너지가 컸어요.
- 한 글이 질의 fanout 전반을 자기완결적으로 커버하고, 답변을 지배할 정답 블록을 갖추는 게 핵심이에요.
이 글의 주제를 우리 브랜드로 확인해 보세요
고객의 한국어 질문에 ChatGPT·Perplexity가 어떻게 답하는지 측정하고 빠진 자리를 찾아 고치는 TRAIL Search가 이 글의 내용을 진단으로 이어 줍니다. 카드 없이 질문 10개로 시작합니다.
다른 글
AI는 두 페이지 중 무엇을 인용할까? 경쟁 인용의 4대 게이트키퍼
생성형 검색에서 경쟁사보다 먼저 인용되려면 콘텐츠에 뭐가 있어야 할까요. 주제 일치·가격 명시·최신 날짜·앞자리 4개 중 하나만 무너져도 인용이 사라진다는 25만 회 실험과 ChatGPT·Gemini의 기준 차이예요.
GEO 논문 45편 서베이: 검증된 기법과 재현 안 되는 기법
GEO 연구 45편을 훑은 서베이예요. 3년간 네 번의 연구 전환, AI 가시성을 나누는 지표 9단계, 본문만 최적화하면 왜 인용이 줄어드는지와 재현되는 기법을 정리했어요.
AI 검색엔진은 어떤 브랜드를 언급할까? 규모·인지도·출처 벤치마크
10만 건 응답으로 다섯 AI 엔진의 브랜드 가시성과 점유율을 측정한 대규모 GEO 벤치마크예요. 브랜드 규모와 인지도의 영향, 엔진마다 다른 언급, 인용 출처가 자사 사이트인지 외부인지 정리했어요.
같은 주제로 이어 읽기
- FeatGEO: AI 인용을 만드는 건 키워드일까 구조일까, 피처 단위 GEO웹페이지를 피처로 추상화해 AI 인용 가시성과 콘텐츠 품질을 동시에 최적화하는 FeatGEO예요. 글자를 고치는 GEO와 피처 단위 GEO의 차이, 사람이 쓴 페이지에 적용하면 어떻게 되는지 정리했어요.
- 구조만 바꿔도 AI 인용이 오를까? 헤딩·문단 길이·문서 골격 실증내용은 그대로 두고 헤딩 단계·문단 길이·강조 표시 같은 문서 골격만 손봐 AI 검색 인용률을 17.3% 올린 실증 연구예요. 엔진마다 선호하는 문서 구조가 다른지도 정리했어요.
- SAGEO Arena: 본문만 고치면 검색에서 빠진다, 제목·메타 필드가 먼저검색·재랭킹·생성 전체 파이프라인에서 GEO 전략을 재평가한 SAGEO Arena예요. AI 검색에서 제목·메타 같은 구조 필드가 본문보다 중요한 이유, 재랭킹 병목에서 살아남는 문서 작성법을 정리했어요.
이 글은 Papers 카테고리에 속해요. 같은 카테고리 글 12편을 한자리에서 볼 수 있어요. Papers 카테고리 글 전체 보기