SAGEO Arena: 본문만 고치면 검색에서 빠진다, 제목·메타 필드가 먼저
검색·재랭킹·생성 전체를 돌려본 현실적 GEO 평가
검색·재랭킹·생성 전체 파이프라인에서 GEO 전략을 재평가한 SAGEO Arena예요. AI 검색에서 제목·메타 같은 구조 필드가 본문보다 중요한 이유, 재랭킹 병목에서 살아남는 문서 작성법을 정리했어요.
SAGEO Arena는 검색·재랭킹·생성 전체 파이프라인을 실제로 돌려서 GEO 전략을 재평가하는 환경이에요. 그 결과, 본문만 고치는 기존 GEO는 생성 단계 이전에 문서를 탈락시켜 현실에선 오히려 역효과라는 걸 보였어요. GEO 원전이나 C-SEO Bench 같은 기존 평가는 이미 검색에 잡힌 후보 문서만 놓고 인용을 재는, 생성 단계만의 게임이었어요 [1][2][3].
문제는 현실의 문서 흐름이에요. 웹페이지가 AI 답변에 인용되려면 먼저 검색에 걸리고, 재랭킹을 통과해 생성기 맥락에 들어가야 해요. 기존 벤치마크는 이 두 관문을 생략하고, 문서의 제목·메타 설명·스키마 같은 구조 신호까지 버린 채 본문만 다뤘어요. 그래서 "통한다"고 보고된 전략이 진짜 파이프라인에서도 통하는지는 검증된 적이 없었어요 [1].
검색·재랭킹·생성을 통째로 돌린다
SAGEO Arena는 171,003개 문서·9개 도메인·2,700개 질의에서 세 단계를 실제로 시뮬레이션해요 [1].
| 단계 | 방법 | 하는 일 |
|---|---|---|
| 검색 | BM25(어휘) | 본문 패시지와 구조 필드를 묶어 상위 100개 선별 |
| 재랭킹 | LLM 교차 인코더 | 질의-패시지 쌍을 채점해 상위 10개로 추림 |
| 생성 | LLM 합성 | 상위 10개로 인용을 단 답변 생성 |
표 1. SAGEO Arena의 3단계 파이프라인 [1]. 세 관문을 모두 통과해야 답변에 인용된다.
검색은 구조 필드별 점수를 역순위 융합(reciprocal rank fusion)으로 합쳐요. 문서 가 여러 필드에서 받은 순위를 이렇게 결합해요 [1].
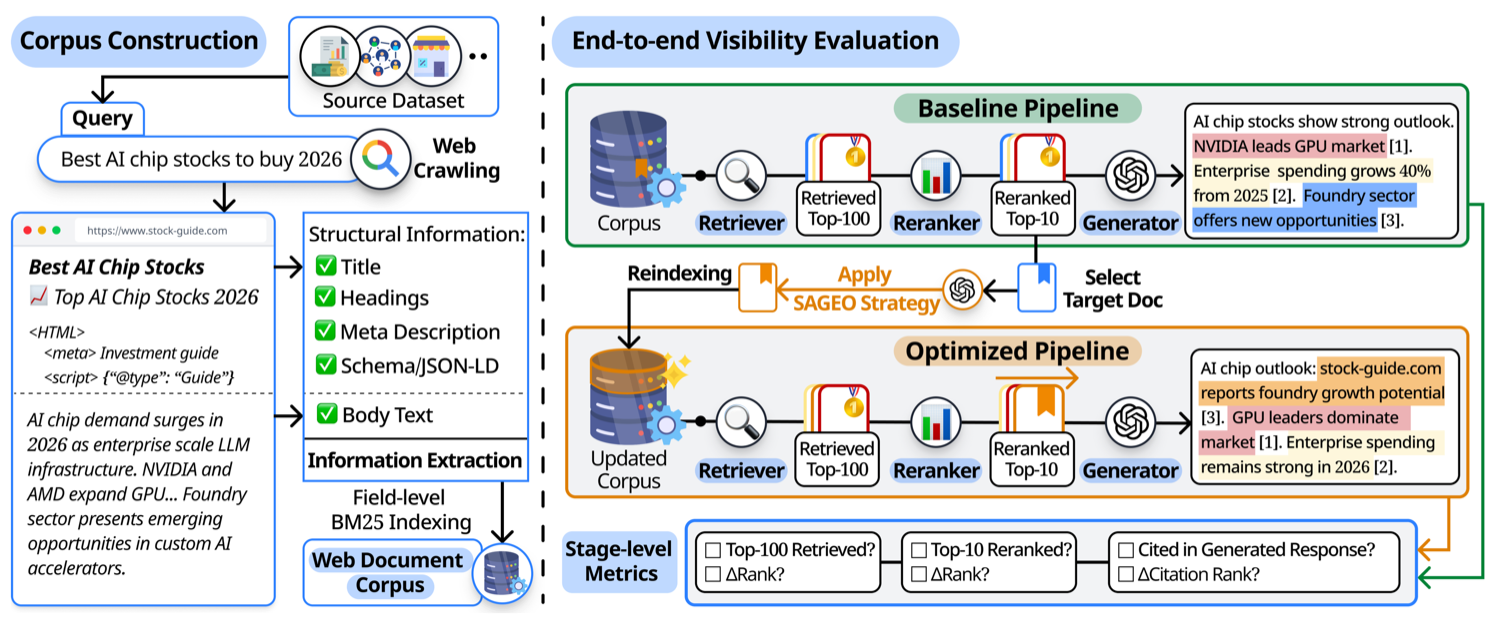
그림 1. 문서가 검색·재랭킹·생성을 차례로 통과하는 경로. 셋을 모두 넘어야 인용된다.
본문만 고치면 검색에서 빠진다
가장 중요한 발견이에요. 본문을 화려하게 바꾸는 기존 GEO 전략은 검색에서 문서를 탈락시켰어요. "eating"을 "alimentary routines" 식으로 고급화하면 사용자 질의와의 어휘 겹침이 줄어 BM25 점수가 떨어지거든요 [1].
| 최적화 | 검색 영향 |
|---|---|
| 전문 용어 추가 | Hit@20 -14% |
| 규칙 학습형(AutoGEO) | 순위 -36% (평균 -22.35위) |
| 구조 필드 최적화 | Hit Rate +22%, 순위 +2.72위 |
표 2. 본문 최적화는 검색에서 역효과, 구조 필드 최적화는 강한 이득 [1].
즉 검색을 끌어올리는 진짜 지렛대는 본문이 아닌 구조 필드(제목·메타 설명·헤딩·스키마) 예요. 구조 필드에 질의 용어와 숫자를 밀집시키면 검색이 오르고, 생성 인용률도 함께 2–7% 올랐어요 [1].
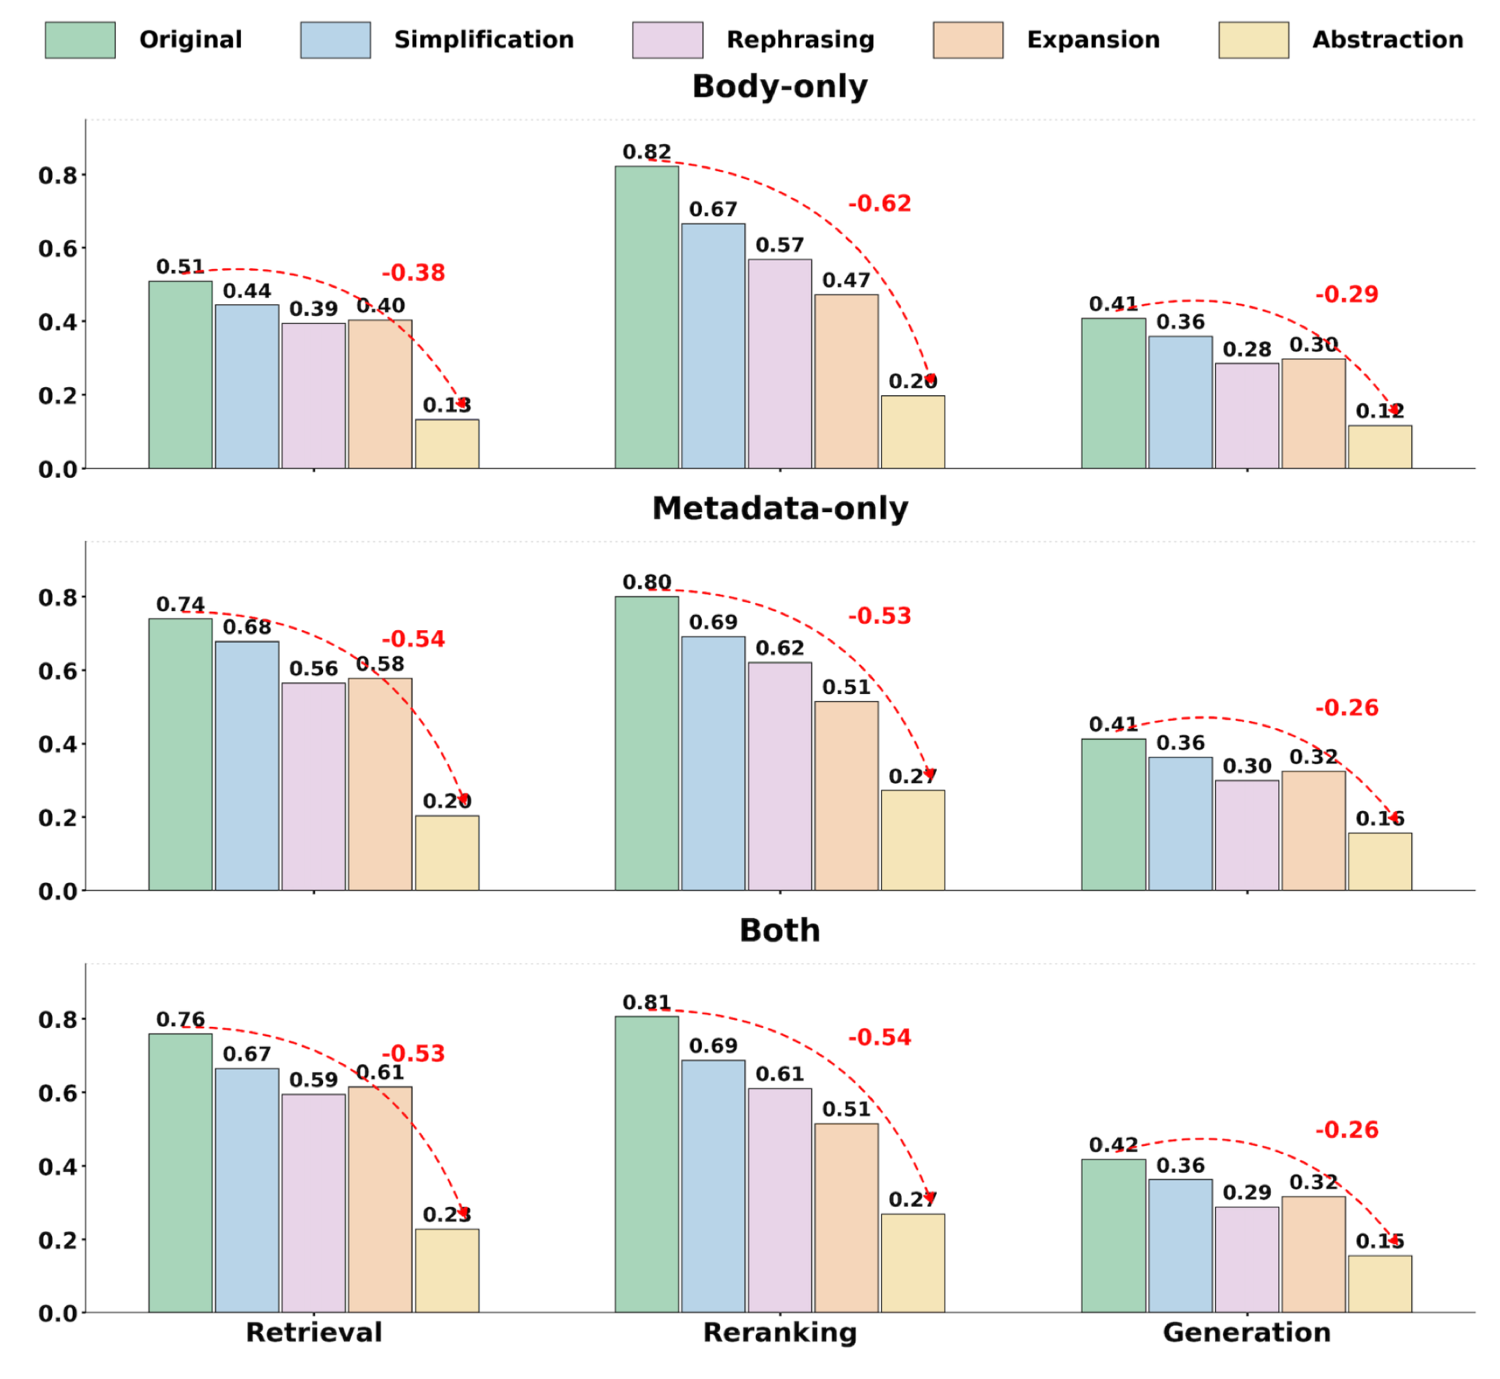
그림 2. 단계별 효과. 검색은 구조 필드가 끌고, 생성 인용은 본문이 끈다.
재랭킹이라는 병목
모든 전략이 재랭킹에서 가시성이 떨어졌어요. 특히 타깃 문서의 5.8%가 순위 10에서 11로 밀려 생성기 컷(상위 10) 밖으로 탈락했어요. 한 칸 차이로 답변에서 사라지는 거예요. 재랭커는 질의 의도를 직접 다루는 내용을 더한 문서, 그리고 답을 앞쪽에 배치한 문서를 선호했어요 [1].
이 때문에 검색과 생성의 역할이 상보적이에요. 검색은 구조가 끌고 인용은 본문이 끌어서, 한쪽만 최적화하면 반드시 다른 쪽이 깨져요. 두 전략을 순진하게 합치면 본문 퇴행이 구조 이득을 상쇄해 전문화된 접근보다 못했어요. 반면 본문과 구조를 단계별로 분리해 최적화한 단계 인지 SAGEO는 검색 Hit@20 +28%·순위 +4.86위에 재랭킹 페널티를 피하고 생성도 +1.01위로, 전 구간에서 우위였어요 [1].
TRAIL 관점: 찾아지고, 그다음 인용되게
이 연구는 우리 제품의 뼈대와 곧장 이어져요. AEO 점수(실시간 인용)와 검색 노출은 분리해서 재야 해요. 인용은 잘 되는데 애초에 검색에서 안 걸리면 성과가 0이니까요. TRAIL Search의 처방도 단계별로 쪼갤 수 있어요.
- 검색에 잡히려면: 제목·메타 설명·헤딩·스키마에 핵심 엔티티와 숫자를 밀집시켜요. 본문을 고급 어휘로 윤색해 질의 어휘 겹침을 깨지 말아요.
- 재랭킹을 통과하려면: 핵심 주장을 문서 앞에 두고, 각 문장에 구체적 근거를 동봉해요. 한 칸 차이로 컷이 갈려요.
- 생성에 인용되려면: 본문 안에 통계·직접 인용·출처 같은 인용 가치 있는 근거를 둬요.
- 도메인부터 보기: 한 전략을 전 도메인에 일괄 적용하지 말아요. 쇼핑 도메인은 일괄 GEO에서 인용이 크게 무너졌어요.
결국 SAGEO Arena는 GEO를 "본문 윤색"에서 "파이프라인 전체 설계"로 넓혀요. 콘텐츠를 인용되게 설계하는 FeatGEO와, 경쟁 하에서 이득이 사라진다는 C-SEO Bench를 이 지도 위에 얹으면, 각 연구가 파이프라인의 어디를 밝히는지 제자리를 찾아요 [3][4].
이 글과 이어지는 내용은 GEO 논문 서베이: 검증된 기법과 재현 안 되는 기법에서 이어져요.
자주 묻는 질문
기존 GEO 평가의 문제가 뭐였나요?
기존 벤치마크는 '이미 검색에 잡힌 후보 문서'만 놓고 인용 여부를 재요. 즉 검색과 재랭킹 단계를 통째로 생략한 생성 단계만의 게임이었어요. 현실에서는 문서가 먼저 검색에 걸려야 생성기 맥락에 들어가는데, 그 관문을 평가에서 빼버린 거예요.
본문만 GEO 최적화하면 어떻게 되나요?
검색에서 오히려 떨어져요. 본문을 고급 어휘로 윤문하면 사용자 질의와의 어휘 겹침이 줄어 검색 점수가 낮아지거든요. 전문 용어 전략은 Hit@20이 -14%, 규칙 학습형은 순위가 -36%였어요. 생성에 잘 보이려는 글쓰기가 검색에 안 잡히게 만들어요.
그럼 무엇을 최적화해야 하나요?
검색은 본문 대신 구조 필드(제목·메타 설명·헤딩·스키마)가 끌어요. 구조 최적화만으로 Hit Rate가 +22% 올랐어요. 생성 인용은 본문이 끌고요. 둘의 역할이 상보적이라 단계별로 따로 최적화해야 해요.
재랭킹은 왜 병목인가요?
모든 전략이 재랭킹에서 가시성이 떨어졌고, 타깃 문서의 5.8%가 순위 10에서 11로 밀려 생성기 컷에서 탈락했어요. 한 칸 차이로 답변에서 사라지는 거예요. 재랭커는 질의 의도를 직접 다루는 내용과 답을 앞에 둔 문서를 선호해요.
참고자료
- [1]Kim et al., "SAGEO Arena: A Realistic Environment for Evaluating Search-Augmented GEO", arXiv:2602.12187 (2026)
- [2]Aggarwal et al., "GEO: Generative Engine Optimization", KDD 2024
- [3]Puerto et al., "C-SEO Bench: Does Conversational SEO Work?", NeurIPS 2025
- [4]Liu & Xu, "Think Before Writing (FeatGEO)", ACL 2026
요약
- SAGEO Arena는 검색(BM25)→재랭킹(LLM)→생성 전체 파이프라인을 실제로 돌려 GEO 전략을 재평가해요.
- 본문만 GEO 최적화하면 어휘 겹침이 줄어 검색에서 탈락해요(전문 용어 -14% Hit, 규칙 학습형 -36% 순위). 생성 이득은 미미했어요.
- 검색을 끌어올리는 진짜 지렛대는 본문이 아니라 구조 필드(제목·메타·스키마)로, 구조 최적화만으로 Hit +22%였어요.
- 재랭킹이 병목이라 타깃의 5.8%가 순위 10→11로 밀려 생성에서 탈락하고, 답을 앞에 둔 자기완결 문서가 유리해요.
- 검색용 구조와 인용용 본문을 단계별로 함께 최적화하는 단계 인지 SAGEO가 전 구간에서 우위였어요.
이 글의 주제를 우리 브랜드로 확인해 보세요
고객의 한국어 질문에 ChatGPT·Perplexity가 어떻게 답하는지 측정하고 빠진 자리를 찾아 고치는 TRAIL Search가 이 글의 내용을 진단으로 이어 줍니다. 카드 없이 질문 10개로 시작합니다.
다른 글
지역 실험으로 마케팅 믹스 모델 보정하는 법: ROAS 숫자 하나 대신 시계열 전체를 쓴다
지역 실험으로 마케팅 믹스 모델을 보정할 때 ROAS 숫자 하나만 쓰면 이월과 포화 정보가 버려진다. 처치·대조 차분식으로 세 파라미터를 추정해 MMM의 ROAS 과대추정을 바로잡은 2026년 논문을 원문 수치로 정리했다.
LLM 추천 시스템의 콜드 스타트를 지식그래프 RAG로 푼다
LLM 추천 시스템이 질문마다 지식그래프 검색량을 스스로 고르게 한 KDD 2026 연구를 정리했다. 콜드 스타트 정확도가 0.39에서 0.50으로 올랐고, 응답 시간은 절반 이하로 줄었다.
RAG 성능은 검색 최적화보다 답변 검증에서 더 오른다
RAG 기능 4종의 16개 조합을 768개 응답으로 비교한 실험에서, 생성한 답의 빠진 측면을 확인하는 완결성 검사 하나가 검색 기능 세 개를 함께 켠 구성보다 품질이 높았다. 지연은 두 배가 됐다.
같은 주제로 이어 읽기
- AI 에이전트는 언제 웹 검색을 할지 이미 알고 있다LLM 에이전트는 웹 검색 같은 도구가 필요한지를 답을 쓰기 전 은닉 상태에 이미 담고 있다(AUROC 0.89에서 0.96). 이 신호로 도구 호출을 48% 줄인 UCSD 연구를 정리했다.
- 생성형 검색은 전통 검색과 다른 사이트를 인용한다구글 검색, AI 오버뷰, 제미나이가 같은 질문에 인용하는 출처는 평균 18%만 겹쳤다. AI 오버뷰는 실제 질문의 51.5%에 뜨고, AI 크롤러를 막은 매체는 인용에서 밀려난다. SIGIR 2026 연구를 정리했다.
- AI 검색은 이름은 알아도 신제품은 추천하지 않는다AI는 이름을 물으면 제품을 99% 알아보지만 '좋은 신제품 추천해줘'에는 3%만 등장한다. Product Hunt 스타트업 112개를 2,240개 질문으로 잰 2025년 연구를 읽고, GEO 점수가 왜 신제품 노출을 못 높였는지 정리했다.
이 글은 Papers 카테고리에 속해요. 같은 카테고리 글 44편을 한자리에서 볼 수 있어요. Papers 카테고리 글 전체 보기