RAG는 어떤 문서를 보고 답했을까? Shapley 값으로 출처 귀속 계산하기
Shapley 값으로 RAG의 근거 문서를 추적하는 법, 그리고 그 한계
RAG가 어떤 검색 문서를 근거로 답했는지 Shapley 값으로 추적하는 연구예요. 계산이 비쌀 때의 근사 대안, 정확한 값과 근사 방법의 선택, 문서가 중복되면 출처 귀속이 틀리는 이유를 정리했어요.
RAG(검색 증강 생성)에서 '출처 귀속'은 AI가 내놓은 답이 실제로 어떤 검색 문서에 기댔는지를 수치로 지목하는 일이에요. Nematov 등의 2025년 논문 Source Attribution in Retrieval-Augmented Generation 은 머신러닝의 Shapley 값을 RAG의 문서 단위로 옮겨서, 이 질문에 체계적으로 답하는 방법과 그 한계를 짚어요 [1]. 콘텐츠가 AI 답변에 인용되게 만드는 GEO 가 '보내는 쪽'의 문제라면, 출처 귀속은 '받는 쪽'에서 무엇을 실제로 썼는지 되짚는 문제예요.
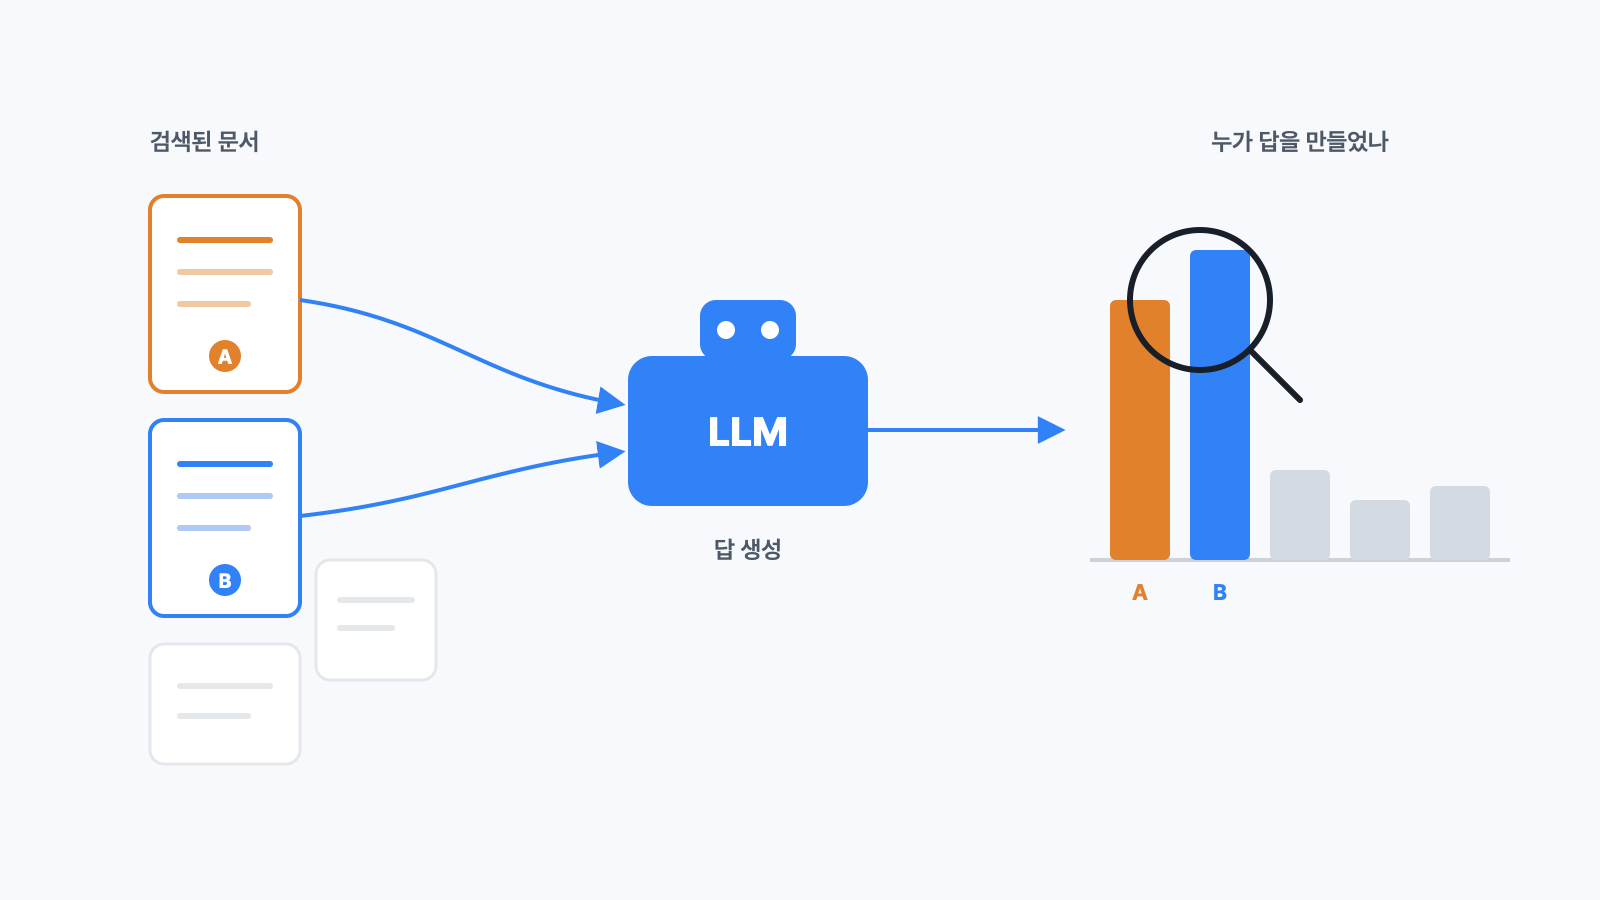
RAG는 질문에 맞는 문서를 먼저 검색해서 LLM에 넣고, 그 문맥을 근거로 답을 만들어요. 답 품질은 좋아지지만 과정은 여전히 블랙박스예요. 열 개를 넣었는데 정작 답을 만든 건 몇 번 문서인지, 검색기가 가져온 문서가 도움이 됐는지 방해가 됐는지 알기 어려워요. 근거 문서를 정확히 지목할 수 있으면 사용자 신뢰가 올라가고, 엉뚱한 문서를 걸러 검색 단계를 개선할 수 있어요.
RAG의 블랙박스, 무엇이 답을 만들었나
문제는 비용이에요. 전통적인 귀속 기법은 입력을 조금씩 바꿔가며 모델을 여러 번 돌려봐야 하는데, LLM에서는 그 한 번이 곧 API 호출이자 돈과 시간이에요. 문서가 n개면 모든 부분집합을 따지는 정확한 계산은 번의 호출이 필요해서, 문서 몇 개만 넘어가도 현실적으로 불가능해져요 [1].
그래서 이 연구의 목표는 세 가지예요. (1) 확립된 귀속 원리를 RAG 문서 단위에 옮기고, (2) 값싼 근사법이 정확한 귀속을 얼마나 재현하는지 재고, (3) 중복·상보·시너지처럼 문서가 얽힌 어려운 상황에서 실제로 쓸 만한지 확인하는 거예요 [1].
Shapley 값으로 기여를 나누는 법
핵심 아이디어는 각 문서를 '협력 게임의 참가자'로 보는 거예요. 문서 집합 에서 문서 의 Shapley 값은, 가능한 모든 부분집합 에 를 더했을 때 늘어나는 효용의 가중 평균이에요 [3][4].
여기서 성과, 즉 효용(utility)을 어떻게 정의하느냐가 관건이에요. 논문은 문서 부분집합 의 효용을, 질의 와 만 줬을 때 LLM이 원래의 전체 문맥 답변 을 생성할 로그가능도로 정의해요. 각 토큰의 로그확률을 teacher-forcing으로 더한 값이에요 [1][2].
특정 문서 묶음이 있을 때 원래 답이 더 그럴듯해질수록 그 묶음의 효용이 높은 거예요. 이 정의 덕분에 SHAP·ContextCite 같은 기존 귀속 기법을 그대로 RAG에 붙일 수 있게 돼요 [1][2].
비교 대상은 정확한 Shapley와 함께 TMC-Shapley, Beta-Shapley, Kernel SHAP, ContextCite, 그리고 가장 단순한 LOO(하나씩 빼보기)예요. 모델은 LLaMA-3.2-8B, Mistral-7B, Qwen-3B를 쓰고, 데이터셋은 BioASQ와 Natural Questions, 그리고 논문이 직접 만든 가상 시나리오를 써요 [1].
실험 1. 싼 방법이 비싼 Shapley를 대신할 수 있을까
첫 실험은 값싼 근사법이 정확한 Shapley 순위를 얼마나 똑같이 재현하는지를 Pearson 상관, Kendall's Tau, Precision@k로 재요.
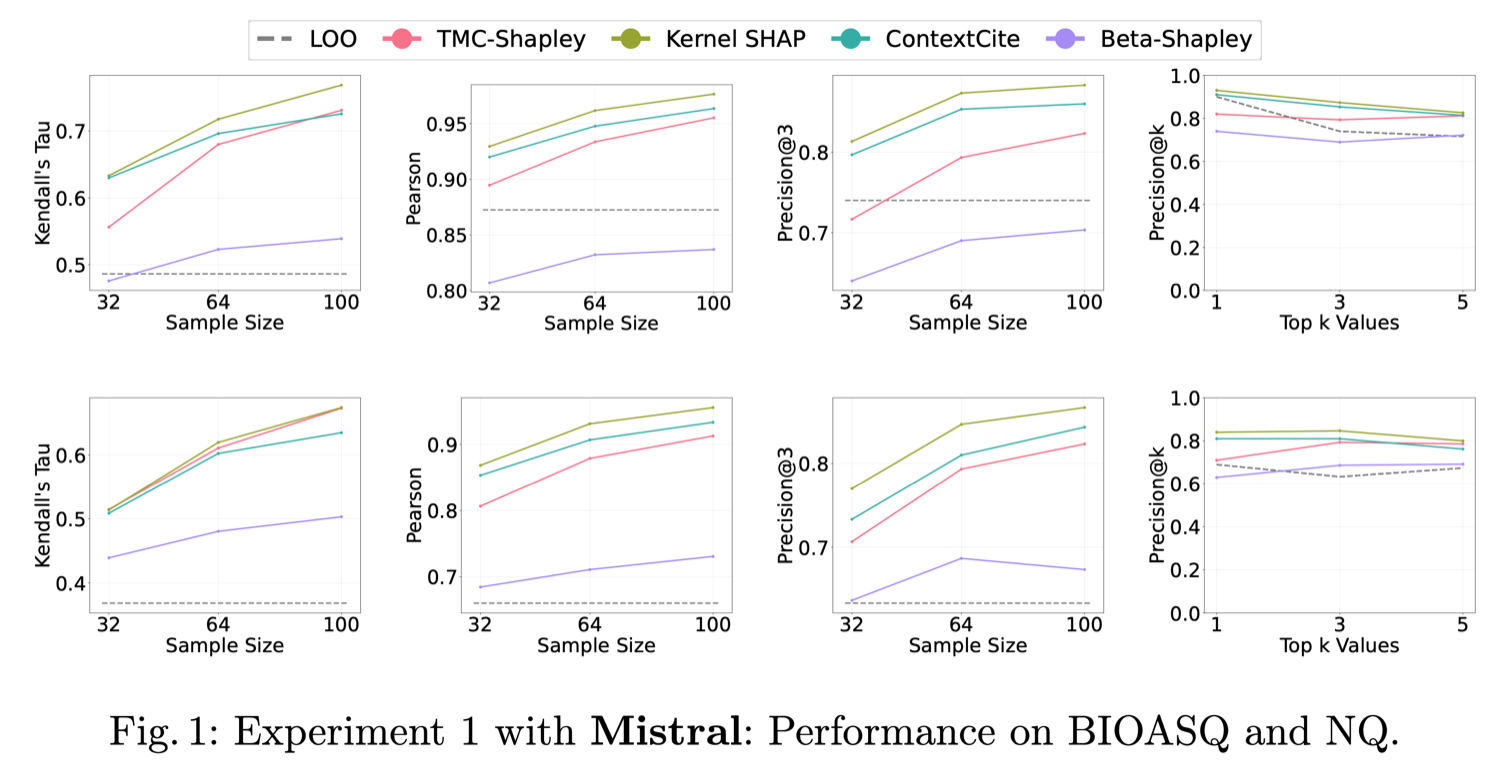
그림 1. 표본 크기(32·64·100)에 따른 각 근사법의 Shapley 재현 정확도.
결과는 뚜렷해요. Kernel SHAP이 대부분의 지표에서 가장 정확했고, ContextCite가 근소한 차이로 뒤따랐어요. 두 방법 모두 단순한 대리 선형 모델을 학습하는 방식이라, 표본을 32에서 64, 100으로 늘리면 성능이 단조 증가하며 Pearson 상관이 0.95를 넘어서요. 반면 TMC-Shapley·Beta-Shapley·LOO는 눈에 띄게 뒤처졌어요 [1]. 가장 중요한 문서 하나를 골라내는 Precision@1은 대체로 0.8 위를 유지해서, 저렴한 방법으로도 핵심 근거는 잘 짚어낸다는 걸 보여줘요 [1].
실험 2. 가장 영향력 큰 문서를 골라내기
두 번째 실험은 '빼면 답이 가장 크게 무너지는' 상위 k개 문서를 각 방법이 얼마나 잘 찾는지를 봐요. Precision@k로 재는데, 정확한 Shapley가 기대대로 가장 높거나 근접했고, Kernel SHAP·ContextCite도 비슷하게 잘 찾았어요. 선형 모델이 가법성 공리를 지키는 덕이에요 [1]. 다만 모든 방법에 약간의 흠이 남았는데, 그 원인이 바로 다음 실험의 주제인 문서 간 의존성이에요.
실험 3. 문서가 얽히면 무너진다
진짜 흥미로운 지점은 문서들이 서로 관계를 맺을 때예요. 논문은 세 가지 상황을 가상 데이터로 설계했어요. 정답이 사전지식으로 새지 않도록 존재하지 않는 지명·인물로 만든 시나리오예요 [1].
그림 2. 문서끼리 얽히는 세 가지 방식: 중복·상보·시너지.
첫째는 중복(redundancy) 이에요. 두 문서가 사실상 같은 정보를 담아서 어느 쪽으로도 답할 수 있는 경우예요.
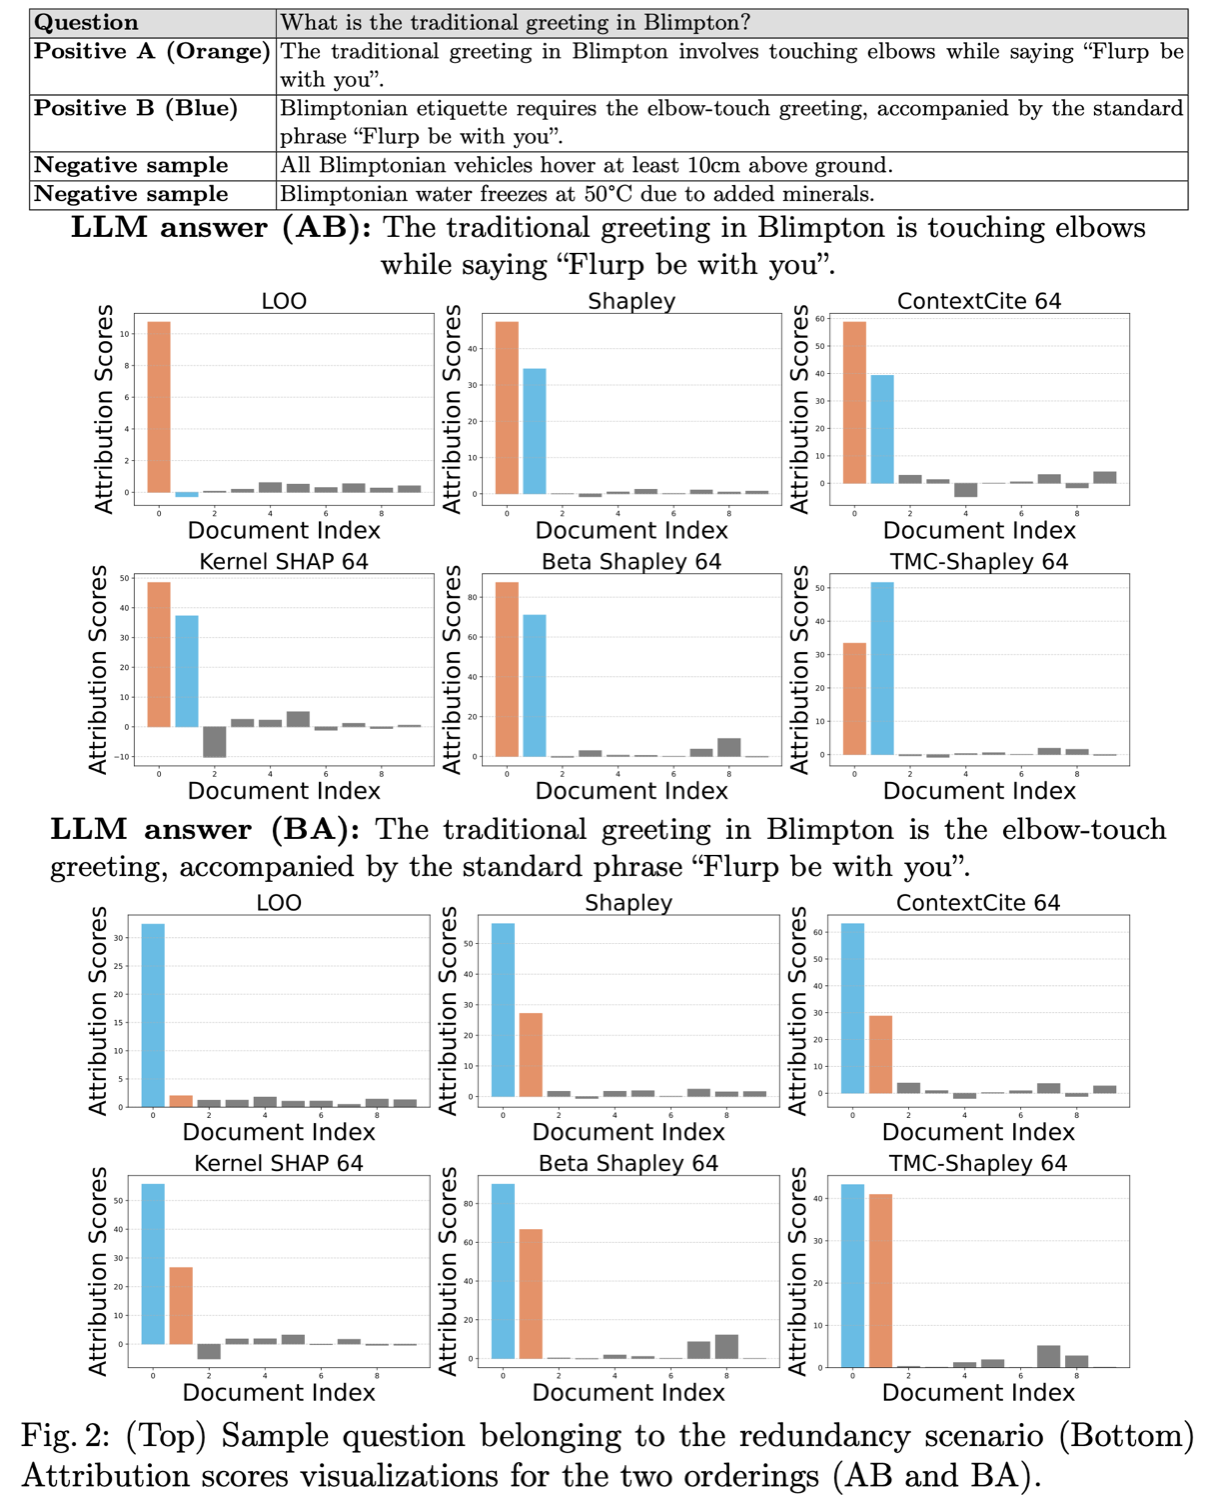
그림 3. 중복 시나리오. 순서를 바꿔도 앞자리 문서가 더 높은 귀속을 받는다.
여기서 위치 편향이 드러나요. 앞에 놓인 중복 문서가 일관되게 더 높은 점수를 받고, 두 문서의 순서를 바꾸면 편향도 따라 뒤집혀요. 내용이 같은데도 자리만으로 점수가 갈리는 거예요 [1].
둘째 상보(complementary) 는 서로 다른 조각을 하나씩 제공해 둘을 합쳐야 완전한 답이 되는 경우예요. 이 상황에서는 모든 방법이 두 문서를 잘 찾아냈어요. 다만 효용 값만으로는 중복과 상보를 구분하기 어렵다는 점이 남아요. 두 경우 모두 한 문서는 높고 다른 문서는 살짝 낮게 나오거든요 [1].
셋째 시너지(다단계 추론) 는 한 문서에서 사실을 끌어낸 다음 다른 문서로 답을 완성해야 하는 경우예요.
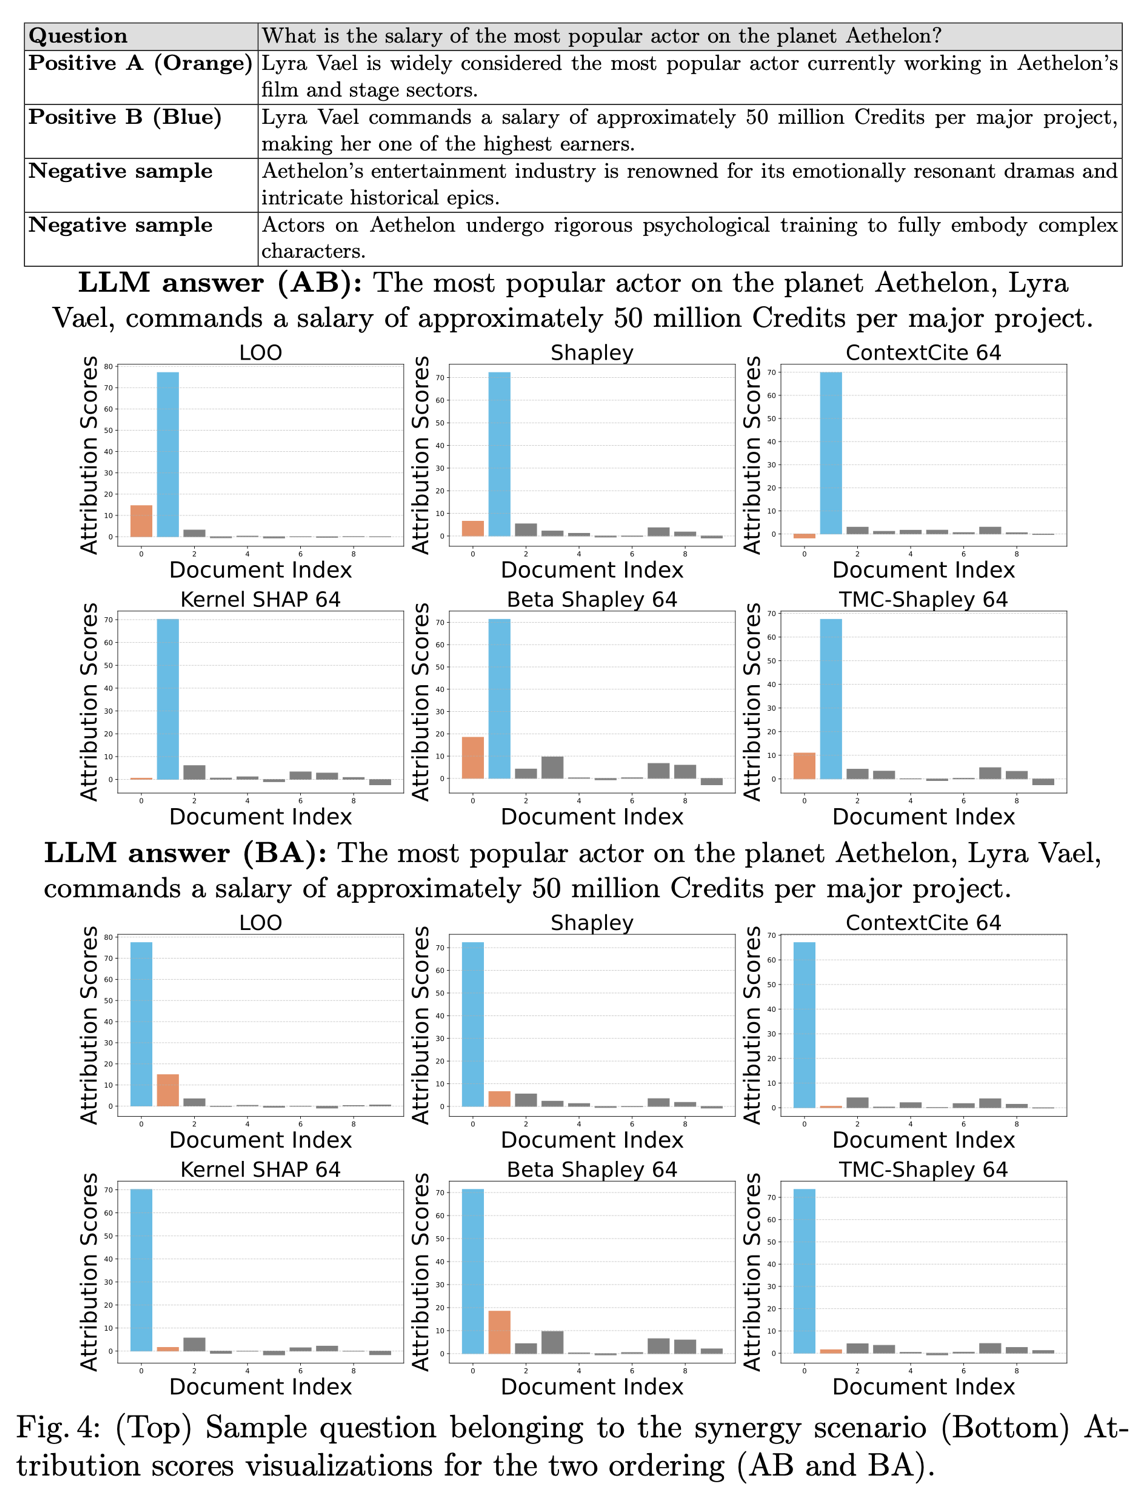
그림 4. 시너지 시나리오. 직접 답을 담은 문서만 크게 평가되고 종합에 필요한 문서는 과소평가된다.
이때 모든 방법이 직접 답을 담은 문서에 점수를 몰아주고, 답을 합성하는 데 꼭 필요한 다른 문서를 과소평가했어요. 순서를 바꿔도 같은 문서가 계속 높은 점수를 받아서 위치 탓도 아니었어요. 모든 질문에 대해 A·B 문서 점수를 정규화해 평균 내면, 답을 담은 'B'가 종합에 필요한 'A'보다 체계적으로 훨씬 높게 나와요 [1].
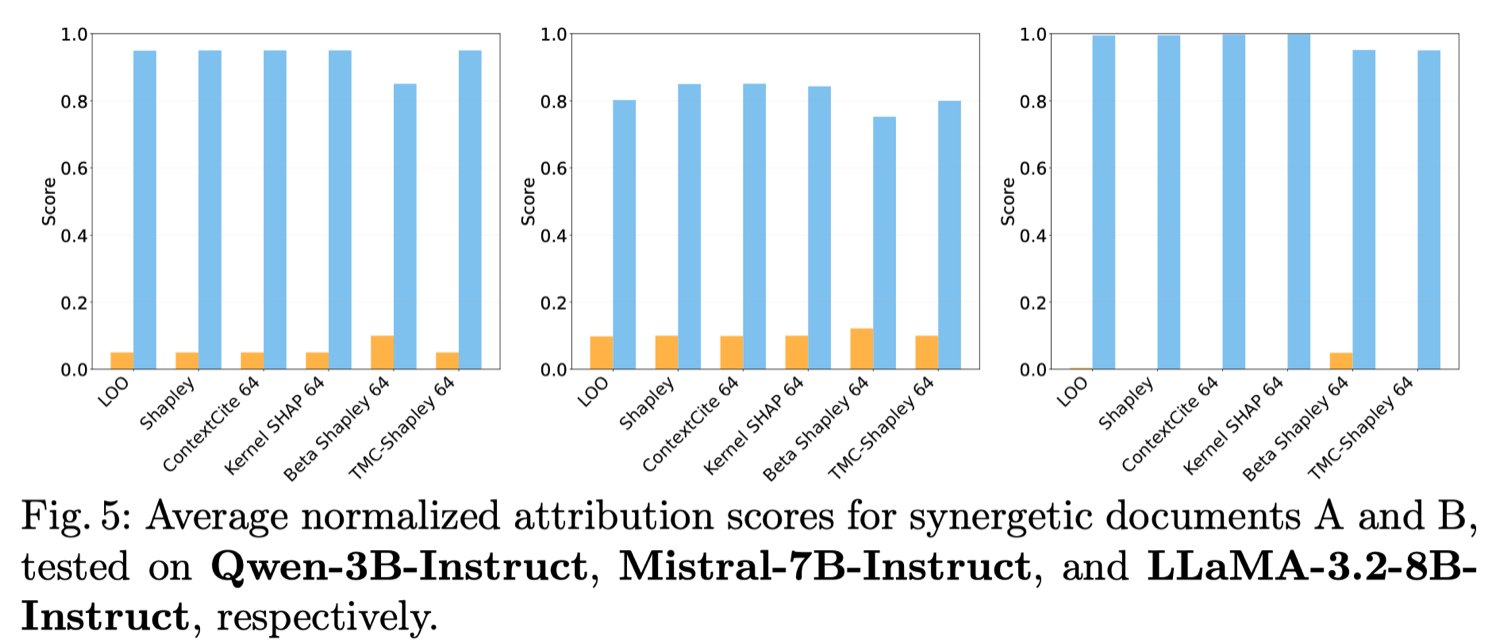
그림 5. 세 모델에서 시너지 문서 A·B의 평균 정규화 귀속 점수. 종합에 필요한 문서가 일관되게 눌린다.
이 방법의 한계
정리하면 맞춤 효용 함수를 얹으면 RAG 출처 귀속이 값싸게도 꽤 잘 작동하지만, 경계도 분명해요 [1].
- 비가법성: 효용(로그가능도)이 가법적이지 않아서 Shapley의 이론적 보장이 완전히는 성립하지 않아요.
- 위치 편향: 내용이 같아도 앞자리 문서가 과대평가돼요.
- 관계 혼동: 효용만으로는 중복과 상보를 구분하기 어려워요.
- 종합 과소평가: 다단계 추론에서 합성에 필요한 문서가 체계적으로 눌려요.
TRAIL 관점: 측정과 설계는 한 쌍
이 연구가 던지는 질문은 우리가 매일 다루는 문제와 닿아 있어요. AEO·GEO에서도 결국 'AI가 이 답을 만들 때 어떤 소스에 기댔나'를 알아야 하고, TRAIL Search는 바로 그 인용·출처 신호를 추적해요. 논문의 교훈은 명확해요. 귀속 점수 하나만 보면 위치 편향이나 과소평가에 속을 수 있으니, 문서 간 관계까지 함께 읽어야 해요.
콘텐츠를 인용되게 설계하는 GEO·FeatGEO 가 '무엇을 담을까'의 문제라면, 출처 귀속은 '무엇이 실제로 쓰였나'를 되짚는 반대 방향의 렌즈예요. AI가 무엇을 근거로 답했는지 제대로 알려면, 높게 매겨진 문서들 사이의 상호작용까지 해석하는 한 걸음이 더 필요해요.
자주 묻는 질문
RAG 출처 귀속이 왜 중요한가요?
AI가 만든 답이 실제로 어떤 검색 문서에 기댔는지 알아야 신뢰·디버깅·검색 품질 개선이 가능하기 때문이에요. 답이 그럴듯해도 엉뚱한 문서에서 나왔다면 그 파이프라인은 언제든 틀릴 수 있어요. 이 논문은 그 근거 문서를 수치로 지목하는 방법을 다뤄요.
Shapley 값이 뭔가요?
협력 게임 이론에서 나온 공정 배분 개념이에요. 전체 기여(답)를 각 참가자(문서)가 얼마나 만들어냈는지, 가능한 모든 조합에서의 평균 기여로 나눠요. 문서마다 '이 답을 만드는 데 얼마나 보탰나'를 하나의 점수로 주는 셈이에요.
가장 정확하면서 저렴한 방법은 뭔가요?
논문 실험에서는 Kernel SHAP이 가장 정확했고 ContextCite가 근소한 차이로 뒤따랐어요. 둘 다 대리(surrogate) 선형 모델을 학습해 정답 Shapley를 거의 그대로 재현하면서 LLM 호출 수를 크게 줄였어요.
이 방법으로 모든 출처를 믿을 수 있나요?
아니요. 문서들이 중복·상보·시너지처럼 서로 얽히면 점수가 왜곡돼요. 특히 앞자리 문서가 더 높은 점수를 받는 위치 편향이 있고, 여러 문서를 종합해야 답이 되는 경우 한 문서를 과소평가해요. 점수만 보지 말고 문서 간 관계까지 함께 해석해야 해요.
참고자료
- [1]Nematov et al., "Source Attribution in Retrieval-Augmented Generation", arXiv:2507.04480 (2025)
- [2]Cohen-Wang et al., "ContextCite: Attributing Model Generation to Context", NeurIPS 2024
- [3]Lundberg & Lee, "A Unified Approach to Interpreting Model Predictions (SHAP)", NeurIPS 2017
- [4]Ghorbani & Zou, "Data Shapley", ICML 2019
- [5]실험·구현 코드 (iNema9590/LLMX)
요약
- RAG 출처 귀속은 'AI가 만든 답이 실제로 어떤 검색 문서에 기댔나'를 수치로 지목하는 일이에요.
- 각 문서의 기여는 Shapley 값으로 나누고, 효용은 원래 답의 로그가능도(log-likelihood)로 정의해요.
- 비싼 Shapley는 Kernel SHAP·ContextCite 같은 대리 모델로 거의 그대로, 훨씬 싸게 재현할 수 있어요. 가장 중요한 문서를 골라내는 정밀도도 높았어요.
- 단 중복·상보·시너지처럼 문서가 얽히면 위치 편향·과소평가가 생겨서, 점수만으로는 부족하고 관계 해석이 필요해요.
이 글의 주제를 우리 브랜드로 확인해 보세요
고객의 한국어 질문에 ChatGPT·Perplexity가 어떻게 답하는지 측정하고 빠진 자리를 찾아 고치는 TRAIL Search가 이 글의 내용을 진단으로 이어 줍니다. 카드 없이 질문 10개로 시작합니다.
다른 글
AI는 두 페이지 중 무엇을 인용할까? 경쟁 인용의 4대 게이트키퍼
생성형 검색에서 경쟁사보다 먼저 인용되려면 콘텐츠에 뭐가 있어야 할까요. 주제 일치·가격 명시·최신 날짜·앞자리 4개 중 하나만 무너져도 인용이 사라진다는 25만 회 실험과 ChatGPT·Gemini의 기준 차이예요.
GEO 논문 45편 서베이: 검증된 기법과 재현 안 되는 기법
GEO 연구 45편을 훑은 서베이예요. 3년간 네 번의 연구 전환, AI 가시성을 나누는 지표 9단계, 본문만 최적화하면 왜 인용이 줄어드는지와 재현되는 기법을 정리했어요.
AI 검색엔진은 어떤 브랜드를 언급할까? 규모·인지도·출처 벤치마크
10만 건 응답으로 다섯 AI 엔진의 브랜드 가시성과 점유율을 측정한 대규모 GEO 벤치마크예요. 브랜드 규모와 인지도의 영향, 엔진마다 다른 언급, 인용 출처가 자사 사이트인지 외부인지 정리했어요.
같은 주제로 이어 읽기
- FeatGEO: AI 인용을 만드는 건 키워드일까 구조일까, 피처 단위 GEO웹페이지를 피처로 추상화해 AI 인용 가시성과 콘텐츠 품질을 동시에 최적화하는 FeatGEO예요. 글자를 고치는 GEO와 피처 단위 GEO의 차이, 사람이 쓴 페이지에 적용하면 어떻게 되는지 정리했어요.
- 구조만 바꿔도 AI 인용이 오를까? 헤딩·문단 길이·문서 골격 실증내용은 그대로 두고 헤딩 단계·문단 길이·강조 표시 같은 문서 골격만 손봐 AI 검색 인용률을 17.3% 올린 실증 연구예요. 엔진마다 선호하는 문서 구조가 다른지도 정리했어요.
- SAGEO Arena: 본문만 고치면 검색에서 빠진다, 제목·메타 필드가 먼저검색·재랭킹·생성 전체 파이프라인에서 GEO 전략을 재평가한 SAGEO Arena예요. AI 검색에서 제목·메타 같은 구조 필드가 본문보다 중요한 이유, 재랭킹 병목에서 살아남는 문서 작성법을 정리했어요.
이 글은 Papers 카테고리에 속해요. 같은 카테고리 글 12편을 한자리에서 볼 수 있어요. Papers 카테고리 글 전체 보기