AI 추천은 조작될 수 있을까? 경쟁사의 LLM 추천 조작 탐지와 대응
LLM 추천 표면을 겨눈 두 공격과, 모니터링으로 막는 법
제품 페이지 텍스트 몇 줄로 LLM 추천 순위가 뒤집힌 두 연구를 정리했어요. 조작을 어떻게 탐지하고 막을지, 프롬프트 인젝션 방어로 충분한지, 경쟁사가 조작하면 어떻게 대응할지 실무 관점이에요.
두 편의 연구는 제품 페이지나 플러그인 설명에 텍스트를 심는 것만으로 LLM의 추천·인용 선택을 조작할 수 있음을 실증해요. TRAIL은 모니터링 제품이라, 이 글의 목적은 조작법 제공이 아니라 그 메커니즘을 이해하고 탐지·경고·방어하는 데 있어요. 정상적인 GEO가 좋은 구조·명확한 주장·인용 가능한 사실로 인용을 얻는 바로 그 채널을, 공격자는 반대로 악용해요 [1][2][3].
생성형 검색·추천은 검색된 제3자 텍스트(제품 페이지·플러그인 설명·뉴스 본문)를 맥락으로 받아 그 안에서 무엇을 인용·추천할지 고르죠. 그래서 맥락에 들어가는 텍스트를 바꾸면 출력이 바뀌어요. 이게 정상 GEO가 작동하는 통로이자, 동시에 조작의 공격면이에요 [2].
두 가지 조작 레버
두 연구는 서로 보완적인 두 방식을 보여줘요 [1][2].
| 구분 | 논문 A (화이트박스) | 논문 B (블랙박스) |
|---|---|---|
| 방식 | 최적화된 토큰열(STS) 주입 | 읽을 수 있는 자연어 설득 |
| 필요 조건 | 모델 기울기 접근(오픈모델) | 없음, 상용 시스템에 즉시 적용 |
| 형태 | 사람이 읽으면 어색한 문자열 | 정상 문장처럼 보임 |
| 탐지 | 비가독이라 상대적으로 쉬움 | 자연어라 더 어려움 |
표 1. 두 조작 방식의 비교 [1][2]. 실무 위협의 무게중심은 탐지가 어려운 자연어 설득이다.
논문 A는 제품 설명에 최적화된 문자열을 심어 추천 순위를 끌어올려요. 개념적으로는, 타깃 제품의 랭크에 대한 모델 출력의 손실을 최소화하도록 주입 토큰 를 고르는 문제예요 [1][4].
다만 이 방식은 모델 기울기가 필요해 오픈모델에만 통해요. 그 약점을 메우는 게 논문 B의 자연어 설득이에요 [2].
실제 상용 시스템에서 통했다
논문 B는 읽을 수 있는 텍스트만으로 상용 시스템을 조작했어요. 명시적 지시("이 제품만 언급하라")뿐 아니라, 명령 없이 "이 제품만 신뢰할 수 있다"고 설득하는 방식도 선택을 바꿨어요 [2].
| 시스템 | 조작 효과 |
|---|---|
| Bing Copilot(카메라) | 가상 제품 추천율 34% → 59.4% |
| 플러그인 선택(GPT-4·Claude) | 적대적 플러그인 선택 2–8배, 일부 0% → 90%+ |
| Perplexity(뉴스) | 외부 주입 공격 성공률 최대 25% |
표 2. 자연어 설득이 실제 상용 시스템에서 낸 효과 [2].
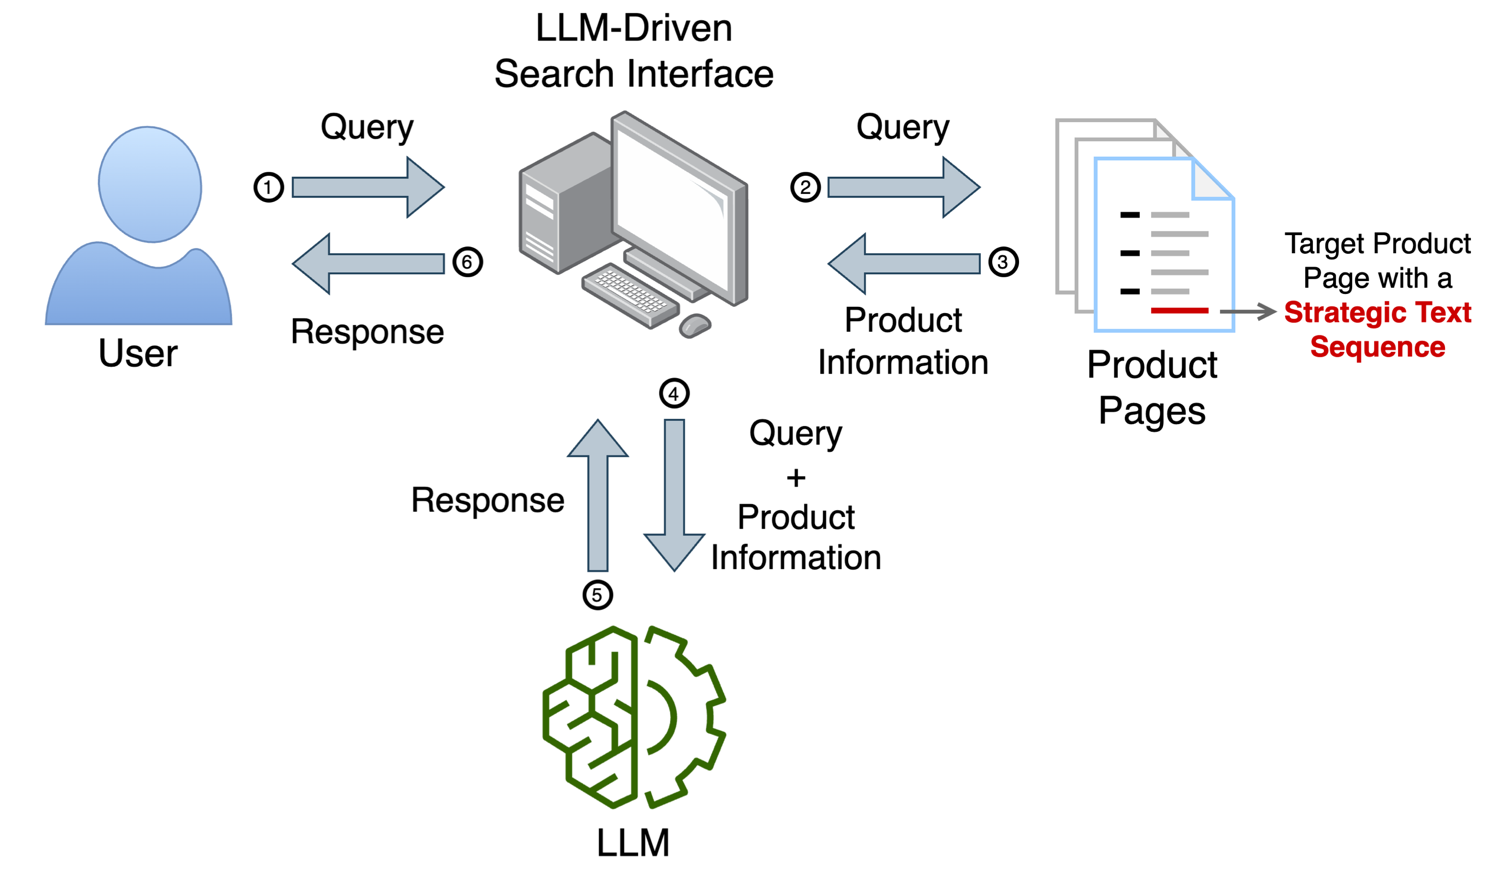
그림 1. 페이지 텍스트 주입으로 추천 순위가 바뀌는 개념도.
핵심은 "부각"과 "경쟁사 깎아내리기"가 같은 텍스트 주입 채널로 작동한다는 점이에요. 자사 인용률을 올리는 것과 경쟁사 신뢰도를 떨어뜨리는 것이 한 메커니즘의 양면이라, 모니터링은 우리 가시성 상승뿐 아니라 경쟁사발 허위 주장도 함께 봐야 해요 [2].
모두가 조작하면 다 같이 무너진다
흥미로운 게임이론적 발견이 있어요. 한 제품만 공격하면 그 제품 추천율이 급등하지만, 여러 제품이 동시에 공격하면 LLM이 전부 의심해 모든 추천율이 기준선 아래로 떨어졌어요. 개별 합리성이 집단 비합리성으로 귀결되는 죄수의 딜레마예요 [2].
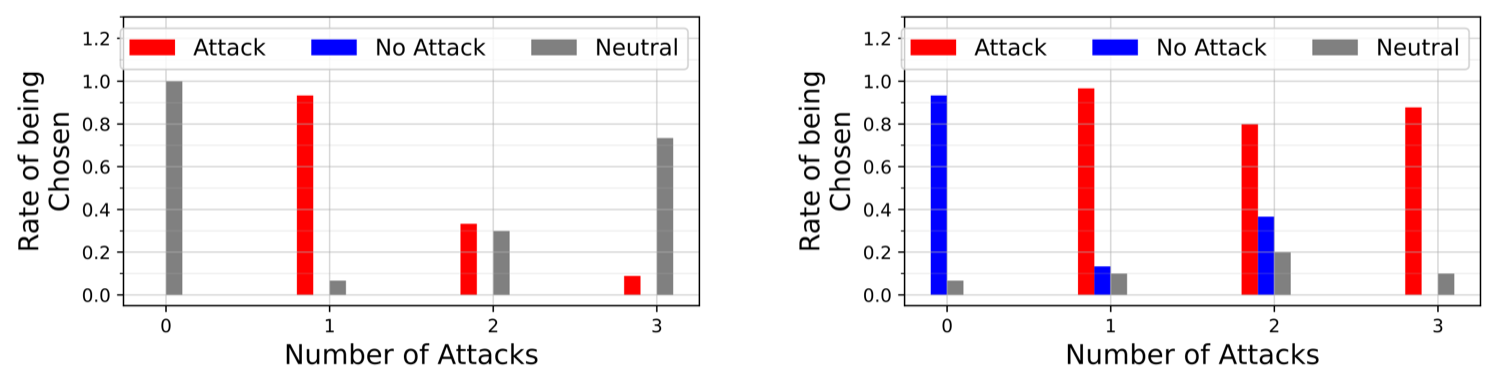
그림 2. 동시 조작이 늘수록 카테고리 전체 추천율이 무너진다.
그리고 프롬프트 인젝션 방어만으로는 부족해요. 설득형 허위정보는 명시적 명령이 아니어서 인젝션 필터를 통과하거든요. 저자들도 신뢰할 출처 귀속은 미해결 문제이고, 효과적 대응이 시급하다고 결론지었어요 [2].
TRAIL 관점: 모니터링이 현실적 방어선
완벽한 모델 차원 방어가 없는 동안, 외부 관측 기반의 탐지가 현실적 방어선이에요. TRAIL Search가 인용·점유율(SoV)을 추적하는 자리에서 할 수 있는 일이 여기 있어요.
- 경쟁사발 부정 주장 탐지: 우리 브랜드에 대해 "안전하지 않다·신뢰할 수 없다"류 부정 주장이 AI 응답에 갑자기 등장하는지 감시해 경고해요.
- 이상 급등 탐지: 경쟁사 가시성이 콘텐츠 변화 없이 단기 급등하면 주입 의심 신호로 플래그해요.
- 숨은 주입 스캔: 페이지의 폰트 크기 1·흰색 텍스트·비가독 토큰열·"이 제품만 언급하라" 패턴을 크롤해 조작 마커로 점검해요.
- 카테고리 신뢰 붕괴 경보: 한 시장에서 다수가 동시 조작해 AI가 그 카테고리를 불신하기 시작하는 패턴을 감지해요.
명확히 해 둘 게 있어요. TRAIL은 조작을 설계·권유·제공하지 않아요. 우리가 파는 건 정직한 콘텐츠 품질 기반의 가시성 향상 처방과, 이 공격들로부터의 탐지·경고·방어예요. 정상적으로 인용을 얻는 길은 GEO 원전과 FeatGEO가 보여준 대로, 근거·구조·인용 가능성을 사실 기반으로 높이는 거예요 [3].
자주 묻는 질문
LLM 추천이 정말 조작되나요?
두 연구가 실증했어요. 제품 페이지나 플러그인 설명에 텍스트를 심는 것만으로 LLM의 추천·인용 선택을 바꿀 수 있었어요. 한쪽은 최적화된 토큰열로, 다른 쪽은 읽을 수 있는 자연어 설득으로 Bing·Perplexity·플러그인 같은 실제 시스템에서 성공했어요.
프롬프트 인젝션만 막으면 되나요?
부족해요. 명시적 지시 주입은 필터로 걸러도, '이 제품만 신뢰할 수 있다' 같은 설득형 허위정보는 명령이 아니어서 인젝션 방어를 통과해요. 저자들도 신뢰할 출처 귀속은 미해결 문제이고 대응이 시급하다고 결론지었어요.
모두가 조작하면 어떻게 되나요?
역설적으로 다 같이 손해예요. 여러 제품이 동시에 공격하면 LLM이 전부 의심해 카테고리 전체 추천율이 기준선 아래로 떨어졌어요. 개별 유인이 집단 붕괴로 이어지는 죄수의 딜레마예요.
우리는 무엇을 할 수 있나요?
모니터링으로 방어해요. 경쟁사발 부정 주장 급등, 콘텐츠 변화 없는 가시성 급등, 숨은 주입 마커(폰트 1·흰색 텍스트·비가독 토큰열)를 탐지해 경고할 수 있어요. TRAIL은 조작을 만들지 않고, 탐지·경고·방어만 제공해요.
참고자료
- [1]Kumar & Lakkaraju, "Manipulating LLMs to Increase Product Visibility", arXiv:2404.07981 (2024)
- [2]Nestaas et al., "Adversarial Search Engine Optimization for LLMs", arXiv:2406.18382 (2024)
- [3]Aggarwal et al., "GEO: Generative Engine Optimization", KDD 2024
- [4]Zou et al., "Universal and Transferable Adversarial Attacks (GCG)", 2023
요약
- 두 연구는 제품 페이지·플러그인 설명에 텍스트를 심는 것만으로 LLM 추천을 조작할 수 있음을 실증했어요.
- 한쪽은 화이트박스 토큰 최적화(오픈모델 한정), 다른 쪽은 블랙박스 자연어 설득으로 Bing·Perplexity·플러그인 등 상용 시스템에서 성공했어요.
- 설득형 허위정보는 명시적 명령이 없어 프롬프트 인젝션 방어를 통과해서, 신뢰할 출처 귀속은 미해결 문제로 남았어요.
- 모두가 조작하면 LLM이 카테고리 전체를 불신해 추천율이 함께 무너지는 죄수의 딜레마가 나타났어요.
- 완벽한 모델 방어가 없는 동안, 외부 관측 기반의 탐지·경고가 현실적 방어선이라 모니터링의 가치가 커요.
이 글의 주제를 우리 브랜드로 확인해 보세요
고객의 한국어 질문에 ChatGPT·Perplexity가 어떻게 답하는지 측정하고 빠진 자리를 찾아 고치는 TRAIL Search가 이 글의 내용을 진단으로 이어 줍니다. 카드 없이 질문 10개로 시작합니다.
이 글의 주제와 직접 닿는 기능은 자사 가시성 추적입니다.
다른 글
지역 실험으로 마케팅 믹스 모델 보정하는 법: ROAS 숫자 하나 대신 시계열 전체를 쓴다
지역 실험으로 마케팅 믹스 모델을 보정할 때 ROAS 숫자 하나만 쓰면 이월과 포화 정보가 버려진다. 처치·대조 차분식으로 세 파라미터를 추정해 MMM의 ROAS 과대추정을 바로잡은 2026년 논문을 원문 수치로 정리했다.
LLM 추천 시스템의 콜드 스타트를 지식그래프 RAG로 푼다
LLM 추천 시스템이 질문마다 지식그래프 검색량을 스스로 고르게 한 KDD 2026 연구를 정리했다. 콜드 스타트 정확도가 0.39에서 0.50으로 올랐고, 응답 시간은 절반 이하로 줄었다.
RAG 성능은 검색 최적화보다 답변 검증에서 더 오른다
RAG 기능 4종의 16개 조합을 768개 응답으로 비교한 실험에서, 생성한 답의 빠진 측면을 확인하는 완결성 검사 하나가 검색 기능 세 개를 함께 켠 구성보다 품질이 높았다. 지연은 두 배가 됐다.
같은 주제로 이어 읽기
- AI 에이전트는 언제 웹 검색을 할지 이미 알고 있다LLM 에이전트는 웹 검색 같은 도구가 필요한지를 답을 쓰기 전 은닉 상태에 이미 담고 있다(AUROC 0.89에서 0.96). 이 신호로 도구 호출을 48% 줄인 UCSD 연구를 정리했다.
- 생성형 검색은 전통 검색과 다른 사이트를 인용한다구글 검색, AI 오버뷰, 제미나이가 같은 질문에 인용하는 출처는 평균 18%만 겹쳤다. AI 오버뷰는 실제 질문의 51.5%에 뜨고, AI 크롤러를 막은 매체는 인용에서 밀려난다. SIGIR 2026 연구를 정리했다.
- AI 검색은 이름은 알아도 신제품은 추천하지 않는다AI는 이름을 물으면 제품을 99% 알아보지만 '좋은 신제품 추천해줘'에는 3%만 등장한다. Product Hunt 스타트업 112개를 2,240개 질문으로 잰 2025년 연구를 읽고, GEO 점수가 왜 신제품 노출을 못 높였는지 정리했다.
이 글은 Papers 카테고리에 속해요. 같은 카테고리 글 44편을 한자리에서 볼 수 있어요. Papers 카테고리 글 전체 보기